AI 时间序列模型能判断 ETF 的涨跌方向吗?
数据:六只期权 ETF(50ETF、300ETF、500ETF、科创 50ETF、创业板 ETF、深证 100ETF)和中证 1000 指数的日线(新浪,经 AKShare);理杏仁指数估值;QVIX;用于微调的 515 个上交所 / 深交所 / 中证 / 申万指数(新浪与申万,经 AKShare);作为第二测试集的 300 只 A 股;期权价格来自每日历史隐含波动率曲面(2024 年起)和我们重建的上交所期权链(2015–2024)。测试窗口:2024-08-01 至 2026-08-25 的周度日期;简单规则的长窗口:2015-02 至 2024-06。
直接使用时,没有一个模型能比简单规则更好地判断期权 ETF 的涨跌方向。微调后,四个模型中有一个(Chronos-2)通过了事先设定的标准。看到这个结果后再做的检验结论不一,所以它进入的是公开的实盘检验,而不是本站的评分。
- 58.5 %:测试窗口内(上涨行情)“永远看涨”判断正确的比例。每一条简单规则、每一个直接使用的模型,正确率都低于它。
- 每笔亏损 ETF 价格的 0.12 %:跟随直接使用的 Kronos 做牛市或熊市价差,扣除成本后的结果。它的预测会用力拉回近期均值:2024-10-08,大涨刚结束,它预测的第一天就已经是 −7.4 %。
- 4 个模型、515 个指数、16,000 步:Kronos-small、Kronos-base、TimesFM 2.5 和 Chronos-2 都用 A 股指数继续训练,并在训练过程中的 8 个点上分别打分。
- 4 个中有 3 个从未通过:Kronos-small、Kronos-base 和 TimesFM 2.5 在任何训练点上都没有预测能力。
- Chronos-2 从 1,000 步到 16,000 步都通过了。 在 2,000 步时,它的正确率为 66.1 %,而“永远看涨”为 58.5 %;残差 rank-IC(残差秩相关系数,见下文)为 +0.40(+0.25 至 +0.50);跟随它做的价差在扣除成本后,比“永远做牛市价差 / 永远做熊市价差”的平均多赚 ETF 价格的 +0.28 %(每笔)。在这段上涨行情里,一律做牛市价差本身就赚了 +0.25 %,所以相对只做多的交易者,它在钱上的优势很小,也不确定;明确的结果是它的排序能力。
- 检验结论不一。 去掉 2024 年的大涨或任何一个半年,它都站得住;在按月打乱的检验中,即使对我们试过的 37 个预测者做了校正,它也站得住。只看最新数据时、以及在更严格的时间平移检验中,它处在边缘;而且它的全部能力都来自约 25 个月里对整个市场涨跌的判断。
- 正在实盘检验:冻结在 8,000 步的 Chronos-2 每晚在模型检验页面上给出预测。这份战绩没有被本研究中的任何选择看到过,它才是定论的检验。大约 6 个月后做第一次查看;以这里测得的优势大小,要得到可靠的答案需要大约一年的预测,如果真实优势更小,还要更久。
- 事先固定:测试日期、规则、指标和通过标准都在计算任何结果之前提交;每个模型的训练计划和“何时停止”的规则都在它自己的结果之前提交。一处偏离计划:计划规定,只有第一个模型(Kronos-small)在训练结束时仍在进步,才微调更多模型。它没有,但我们还是又微调了三个。这是看到结果之后做出的最大的选择。
问题
本站的大多数策略都需要一个方向判断:牛市看跌价差在 ETF 不跌时盈利,熊市看涨价差在它不涨时盈利。本站的评分不猜方向,只用期权数据给一笔交易打分(见行权价权利金研究)。一个能判断方向的模型可以作为评分之上的第二层:在牛市价差和熊市价差之间做取舍。
新的时间序列基础模型在非常多的序列上训练,能预测它们从未见过的序列(“零样本”,zero-shot)。其中 Kronos 是在股票和基金的 K 线上训练的,包括 A 股。所以我们问了两个问题:
- 零样本:这些模型直接使用,能否预测每只 ETF 到下一个到期日是涨是跌,并且在扣除交易成本后胜过简单规则?
- 微调:如果用 A 股数据继续训练它们,能好多少?好处从哪一点开始、在哪一点停止?
诚实的起点很低:一周到一个月的指数方向接近不可预测,而六只 ETF 一起涨跌,几乎等于一个序列。
我们怎么检验
- 序列:六只期权 ETF 和中证 1000 指数(IM 期权的标的)。
- 日期:从 2024-08-01 到 2026-08-25 的每一周(101 个日期)。Kronos 的训练数据止于 2024 年 6 月,所以每个测试日期都在它之后:没有模型见过答案。
- 期限:到下一个 ETF 到期日(主测试),另加 1 周和 1 个月。
- 要胜过的简单规则:20 日和 60 日动量、5 日反转、估值百分位(便宜 → 看涨)。另有两个参照:抛硬币,和过去上涨的比例。
- 模型:Kronos-small 与 Kronos-base、TimesFM 2.5、Chronos-2,以及加入 QVIX 和估值作为额外输入的 Chronos-2。
- 指标:
- 命中率:方向判断正确的比例,与 50 % 和“永远看涨”比较;
- 残差 rank-IC(残差秩相关系数,rank information coefficient):去掉动量、反转和估值已经能解释的部分之后,预测能否把结果排对顺序?它能识别出只是已知规则“换了个外衣”的模型;
- Brier 分数:“上涨”概率的好坏(抛硬币得 0.25,越低越好);
- 价差盈亏:按预测方向做牛市看涨价差或熊市看跌价差(30 delta / 15 delta 行权价),持有到期,扣除买卖价差成本,以 ETF 价格的 % 计。
- 通过标准:只有同时满足以下几点,模型才算有预测能力:残差 rank-IC 连同 95 % 区间都在零以上;价差在扣除成本后胜过“永远做牛市价差 / 永远做熊市价差”的平均(区间在零以上),并且本身赚钱;Brier 分数好于抛硬币;而且这些在测试窗口的前后两半里都要成立。区间来自按日历月的自助法(bootstrap),因为七个序列是同一个市场。
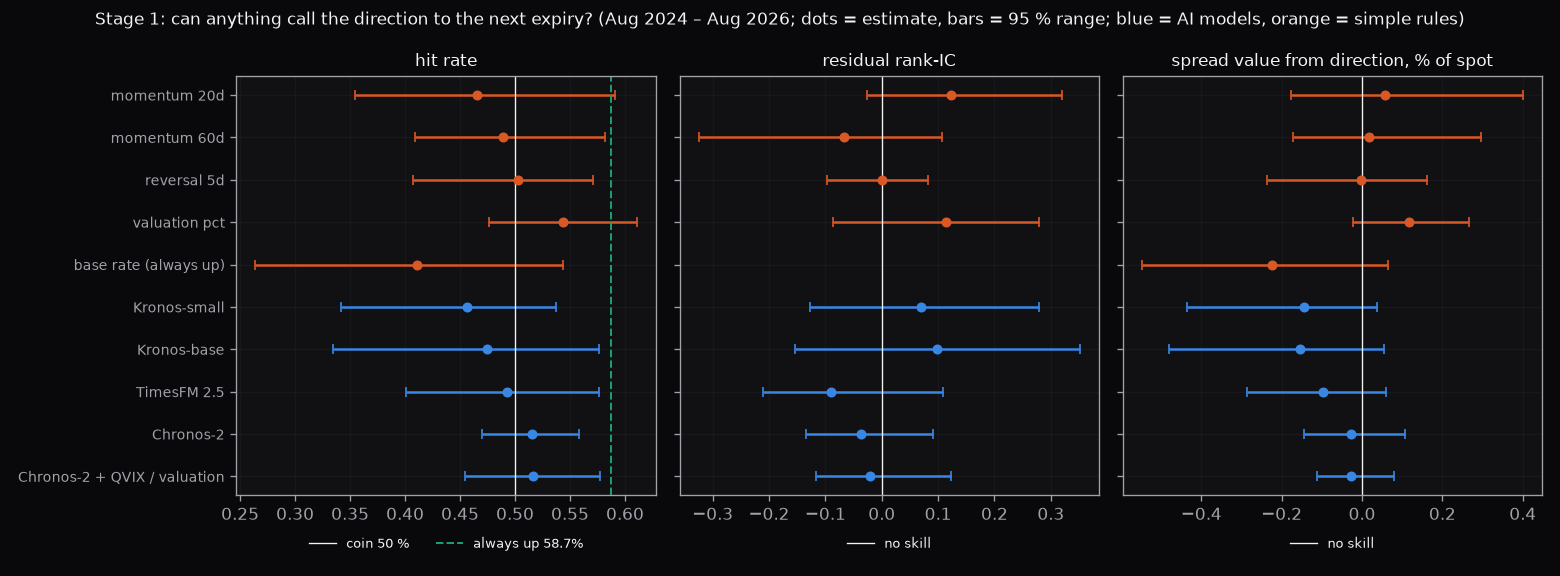
零样本模型与简单规则,测试窗口 2024 年 8 月 – 2026 年 8 月,期限到下一个到期日。
零样本:没有预测能力,而且 Kronos 自信地预测错误
- 命中率。 每一个模型和规则的正确率都低于“永远看涨”(58.5 %)。最好的是估值百分位,54.4 %(47.6 % 至 61.1 %)。模型在 46–52 % 之间。
- 残差能力。 没有一个残差 rank-IC 连同区间在零以上:Kronos-small +0.07(−0.13 至 +0.28)、Kronos-base +0.10、TimesFM 2.5 −0.09、Chronos-2 −0.04、加入 QVIX 和估值的 Chronos-2 −0.02。
- 概率。 TimesFM 和 Chronos-2 接近抛硬币(Brier 0.257–0.271,硬币为 0.25)。Kronos 自信地预测错误(small 0.445、base 0.494):它的预测路径会用力拉回过去 256 天的均值。它的 1 周预测平均是 −5.2 %,而 ETF 实际涨了 +0.5 %。
- 扣除成本后的价差。 跟随 Kronos 做的价差每笔亏损 ETF 价格的 0.12 % 至 0.14 %,区间在零以下。没有一个预测者的方向为价差带来价值。
- 长窗口。 在 2015–2024 年(只测简单规则;模型的训练数据覆盖这些年份),动量、反转和估值的正确率为 49–52 %,没有残差能力。其中包括 2015 年股灾、2018 年、2020 年 2 月和 2021 年。
微调四个模型:三个失败,Chronos-2 通过
我们用 515 个 A 股指数继续训练四个模型:来自上交所、深交所、中证和申万的行业、风格和规模指数,日线截至 2023-12-29。ETF 自己的指数,以及日涨跌与它们相关性达到 95 % 及以上的指数,都被排除在外,所以没有模型用测试对象做训练。同一批指数的 2024 年 1 月至 7 月作为验证段。每个模型训练 16,000 步(每步 32 个窗口),并在 0(未训练)、250、500、1,000、2,000、4,000、8,000 和 16,000 步时分别打分,打分方式与零样本测试完全相同。最先做的是 Kronos-small;它失败之后,我们又训练了另外三个,它们的规则同样在得到任何结果之前就写定了。
| 模型 | 是否通过标准 | 最好的残差 rank-IC(步数) | 训练后的 Brier | 验证损失最低处 |
|---|---|---|---|---|
| Kronos-small | 从未通过 | +0.14(2,000) | 0.31–0.36 | 8,000 步 |
| Kronos-base | 从未通过 | +0.17(2,000) | 0.31–0.41 | 2,000 步 |
| TimesFM 2.5 | 从未通过 | +0.07(500) | 0.26–0.35 | 250 步 |
| Chronos-2 | 1,000 至 16,000 步 | +0.40(2,000) | 0.22–0.25 | 500 步 |
- Kronos-small 和 Kronos-base:微调修好了它们的过度自信(small 的 Brier 从 0.445 降到 0.31–0.36),Kronos-small 也学会了给自己那一类数据排序(留出指数上的 rank-IC 从 −0.09 升到 +0.26)。但这些都没有迁移到 ETF,也没有迁移到它从未见过的 300 只股票。Kronos-base 在 ETF 上的残差 rank-IC 在 2,000–4,000 步时高于它未训练时的水平,但从未明显高于零。
- TimesFM 2.5 死记了它的训练窗口(训练损失从 0.51 降到 0.09),而验证损失在 250 步之后再没有改善;它的概率反而变差了。
- Chronos-2 从 1,000 步起的每个训练点都通过了,并且在测试窗口的前后两半都成立:
| Chronos-2,步数 | 命中率 | 残差 rank-IC | Brier | 扣除成本后的价差价值 |
|---|---|---|---|---|
| 0(零样本) | 52 % | −0.04 | 0.258 | −0.03 % |
| 500 | 54 % | +0.17 | 0.248 | +0.08 % |
| 1,000 | 61 % | +0.29 | 0.235 | +0.19 % |
| 2,000 | 66 % | +0.40 | 0.223 | +0.28 % |
| 8,000(正在实盘检验) | 63 % | +0.39 | 0.229 | +0.25 % |
| 16,000 | 63 % | +0.33 | 0.234 | +0.29 % |
- 它的验证数据并不支持它。 Chronos-2 在留出指数上的损失在 500 步时最低,随后上升;而它在从未训练过的 2023 年窗口上的损失一直在下降。这说明 2024 年初是一个不同的市场,而不是程序错误;但这也意味着,如果按验证数据来选,会选到 500 步,而 500 步并没有通过。
- 单看命中率,它的优势在任何训练点都不确定:在 2,000 步时比“永远看涨”高 7.5 个百分点(区间 −1.1 至 +13.6),在 8,000 步时高 4.8 个百分点(−7.0 至 +14.1)。
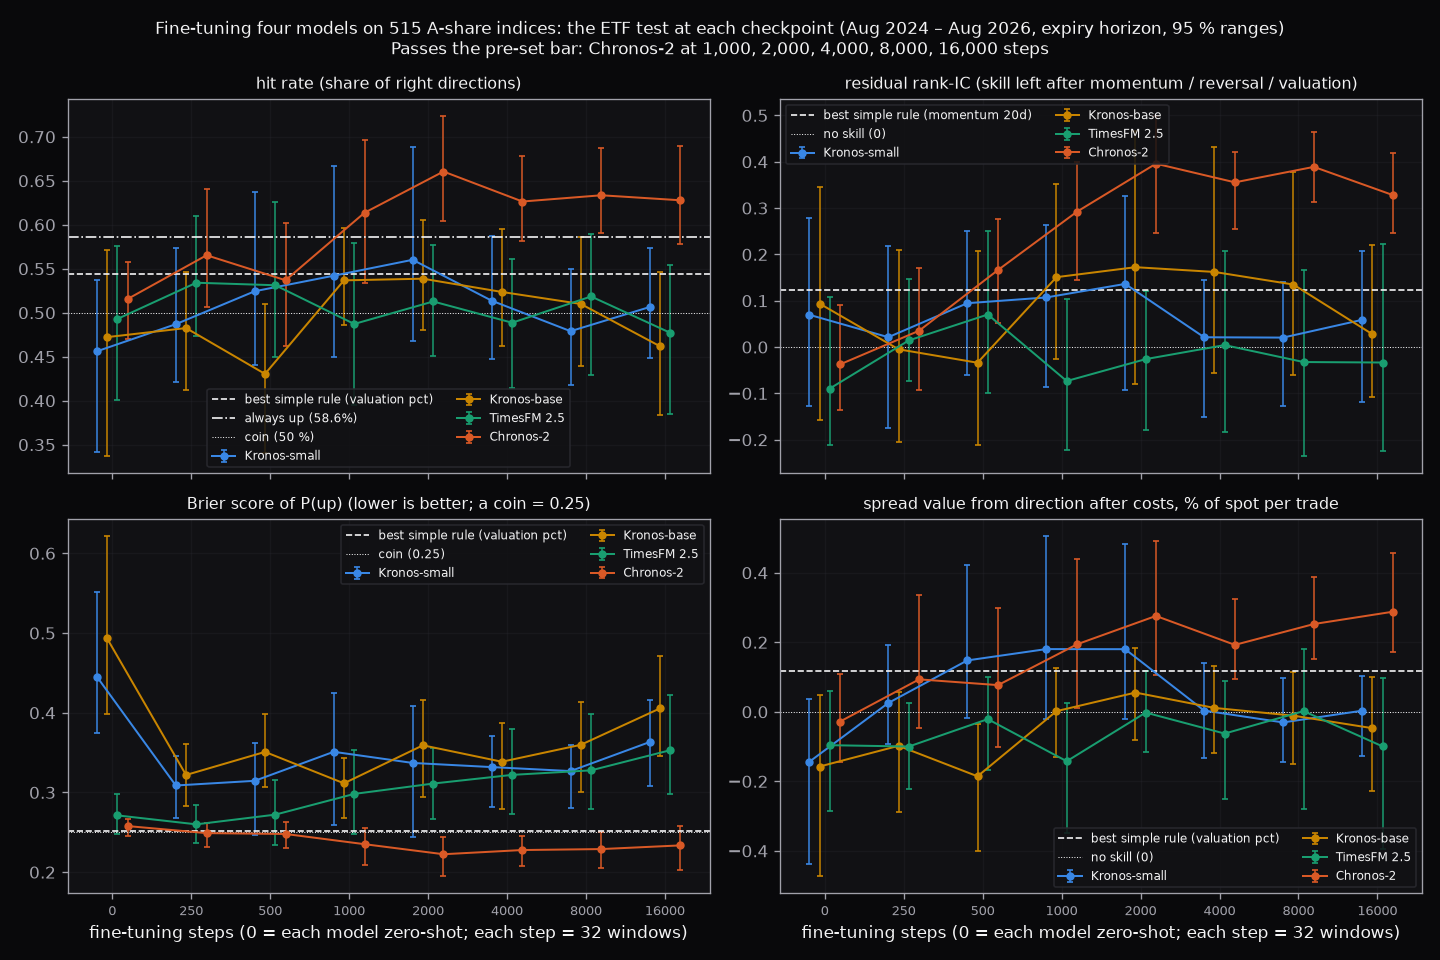
学习曲线:用 515 个 A 股指数微调的四个模型,在每个训练点上对 ETF 打分。
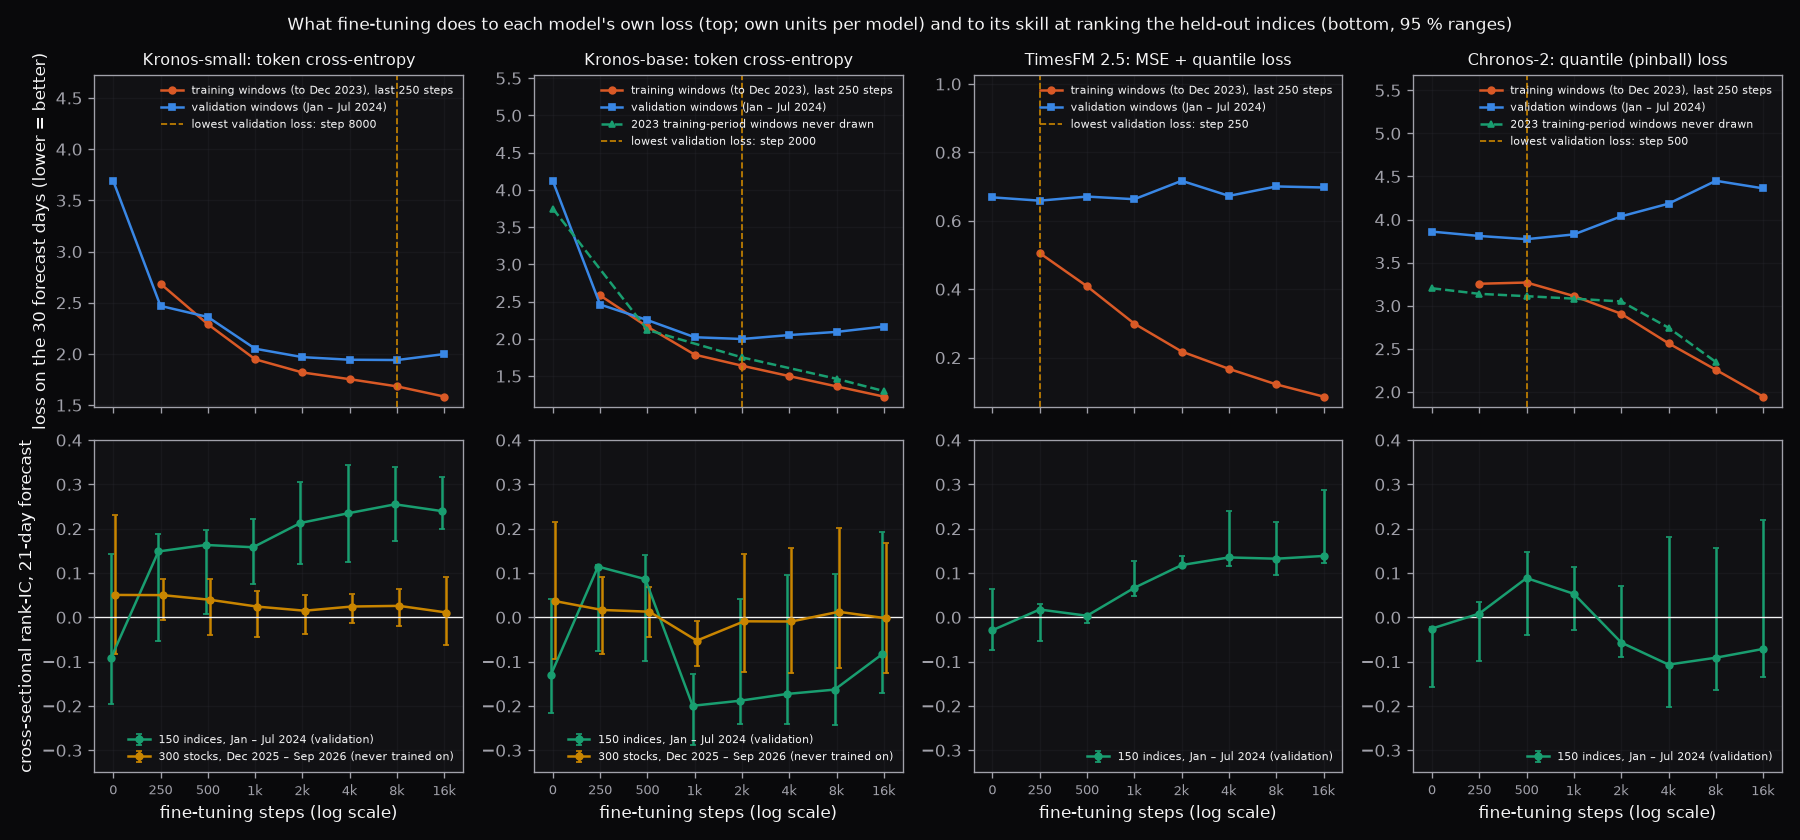
微调中每个模型学到了什么,这种能力停留在哪里。
Chronos-2 的结果是真的吗?事后做的检验
这些检验是我们在看到 Chronos-2 通过之后才选的,所以它们只是证据,不是第二道标准。
- 去掉一个时期:站得住。 去掉 2024 年 9–10 月的大涨,或者去掉任何一个半年,它从 1,000 步到 16,000 步的残差 rank-IC 都在 +0.22 到 +0.43 之间,每个区间都在零以上。
- 只看最新数据:处在边缘。 从 2025 年 10 月起(所有模型都已发布之后),2,000 步时为 +0.36(−0.12 至 +0.56),区间包含零;8,000 步时为 +0.36(+0.19 至 +0.44)。
- 按月打乱:站得住。 把整月的预测随机互换 5,000 次,几乎从未得到这么高的 rank-IC(2,000 到 16,000 步的 p 值为 0.0002–0.0006)。对我们试过的 37 个预测者做多重检验校正后,它仍低于 0.05(严格的 Bonferroni 校正为 0.007–0.022,Benjamini–Hochberg 校正为 0.005–0.006)。其他预测者即使不做校正,也没有一个低于 0.05。
- 时间平移:结果很强,检验很弱。 把预测沿日期平移 5 到 96 周,会保留预测自身缓慢的漂移,而打乱会破坏它。真实的预测以很大的差距胜过全部 92 种平移(8,000 步时 rank-IC 为 +0.39;最好的平移为 +0.21)。但 92 种相互重叠的平移给出的 p 不可能小于 0.011,对 37 个预测者校正后为 0.40(Bonferroni)或 0.099(Benjamini–Hochberg)。无论预测多好,这个检验的平移次数都太少,过不了这一校正。
- 它做的是:判断整个市场的涨跌。 它预测的是七个序列是否一起涨或一起跌;它不能分辨同一天哪只 ETF 会比另一只表现更好(同一日期各 ETF 之间的 rank-IC ≈ 0)。在每个半年内部,它的能力比整个窗口弱;它的命中率只在两个下跌的半年里(2024 年下半年和 2026 年 7–8 月)明显胜过“永远看涨”。
- 没有发现未来数据。 用每个日期为止的原始价格和分红重新构建输入,结果与存储的输入完全相同。
- 还有一个事后的选择:正在实盘检验的 8,000 步,是在这些结果已知之后才选定的。
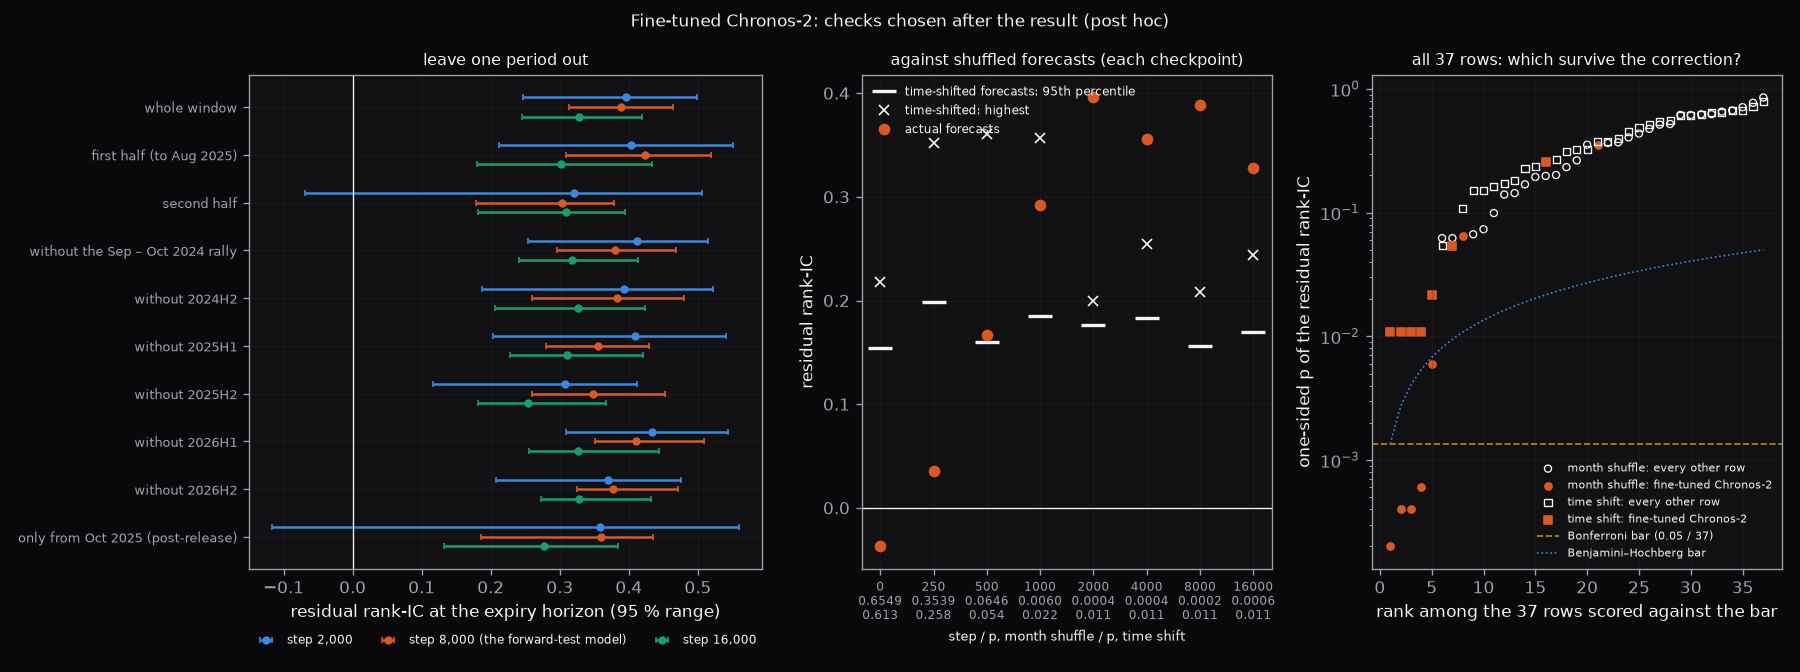
看到 Chronos-2 的结果之后做的检验。
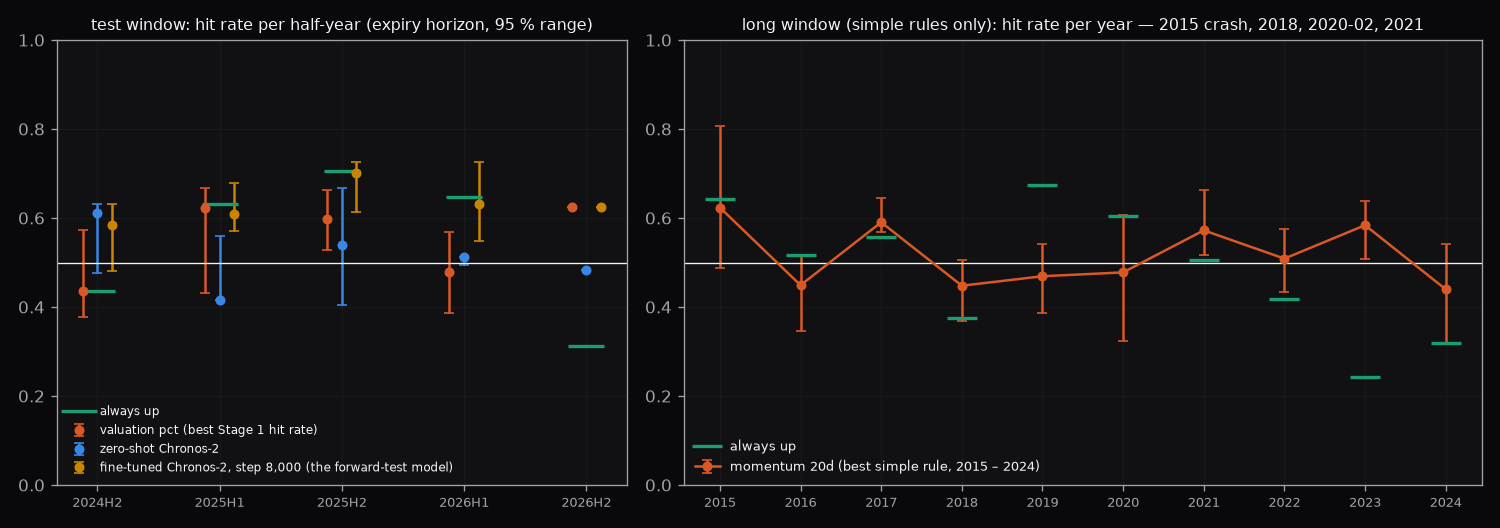
有没有哪一部分随时间稳定?左:按半年划分的测试窗口。右:2015–2024 年最佳简单规则逐年表现。
它的预测长什么样
下面是正在检验的 Chronos-2 模型(8,000 步)的十个预测(每个都预测到 1–6 周后的下一个到期日),从测试窗口中随机抽取:五组各两个(强烈看涨、中等看涨、弱、中等看跌、强烈看跌;强 = 概率距 50 % 超过 20 个百分点,中 = 10–20 个百分点,弱 = 不到 10 个百分点)。抽取方式在查看结果之前就已固定,所以猜错的预测按实际情况出现。
| 日期 | 标的 | 上涨概率(强度) | 预测中间值 | 实际涨跌 | 猜对? |
|---|---|---|---|---|---|
| 2024-08-29 | 300ETF | 32 %(中) | −0.9 % | +3.8 % | 否 |
| 2024-09-05 | 500ETF | 26 %(强) | −1.5 % | +3.0 % | 否 |
| 2024-09-12 | 500ETF | 24 %(强) | −1.7 % | +5.3 % | 否 |
| 2025-02-05 | 50ETF | 41 %(弱) | −0.6 % | +4.1 % | 否 |
| 2025-08-27 | 中证 1000 | 88 %(强) | +4.7 % | +1.4 % | 是 |
| 2025-09-24 | 300ETF | 39 %(中) | −0.7 % | +0.7 % | 否 |
| 2025-11-27 | 科创 50ETF | 60 %(中) | +1.3 % | +3.2 % | 是 |
| 2026-03-31 | 300ETF | 50.4 %(弱) | +0.0 % | +7.8 % | 是(只差 0.4 个百分点) |
| 2026-03-31 | 500ETF | 62 %(中) | +1.0 % | +10.1 % | 是 |
| 2026-06-30 | 深证 100ETF | 71 %(强) | +2.6 % | −9.8 % | 否 |
- 这 10 个中有 4 个猜对;在全部 704 个测试预测中,正确率为 63.4 %。 十个预测远不足以判断一个模型的好坏,这也是实盘检验需要几个月的原因。
- 其中三个猜错的预测,是在 2024 年 9 月下旬大涨之前看跌。 它们都计入了测试和上面的每一个数字。
- 预测中间值相对实际涨跌很小。 模型预测的是一个很宽的结果范围;它的中间值不是目标价,打分只看上涨概率。
这对本站意味着什么
- 评分里暂时没有方向观点。 评分继续只用期权数据给交易打分,策略网格继续把牛 / 熊的选择留给你。推荐交易和仓位大小都不使用任何模型预测。
- 改为实盘检验。 冻结在 8,000 步的 Chronos-2,在每个交易日收盘后预测七个标的各自到下一个到期日的涨跌方向,发布在模型检验页面上,战绩从 2026-10-15 起公开记录。这些预测没有被本研究中的任何选择看到过,所以它们是干净的检验。几十次预测分不清能力和运气,所以判定规则在第一个结果出来之前就已固定:积累 12 个月的每周预测之后(约 2027 年 11 月),如果残差 rank-IC 大于零、且按月打乱检验的 p 小于 0.05,检验就算通过;6 个月时的第一次查看只报告数字。
- “永远看涨”是这个窗口里最好的简单规则,但只是因为市场在上涨。它不是预测:在 2015–2024 年它只有 48–49 % 的时候是对的。
注意事项
- 大约 25 个独立月份。 七个序列作为一个市场同涨同跌,窗口还相互重叠。残差 rank-IC 大约要到 0.2 才能越过零;Chronos-2 的 +0.3 至 +0.4 做到了,但依据的只是一个市场的涨跌。
- 上涨的测试窗口。 “永远看涨”有 58.5 % 的时候是对的,每个预测者都必须胜过它。在下跌市场里,这个门槛会不同。
- Brier 门槛很低。 它只要求比抛硬币(0.25)好;一律说“58.5 % 上涨”就能得到 0.243。Chronos-2 在 8,000 步时的 0.229 只比它好 0.014。
- 不是每个预测都有用。 它中等程度的看跌预测(上涨概率 30–40 %)只有 46.5 % 的时候是对的(86 次);强烈看涨的预测为 81.4 %(167 次)。模型检验页面按强度展示了这一点。
- 试了很多次,只有一个窗口。 37 个预测者在同一批日期上打分,正在检验的训练点是在结果出来之后选的,上面的检验也是在通过之后才选的。多重检验校正只覆盖这 37 次尝试,不覆盖这些选择;实盘检验不受其中任何一项影响。
- 价差用的是模型价格。 价差价格来自每日隐含波动率曲面、按实测远期价格计算,买卖价差成本取自本站保存的收盘报价(比盘中更宽)。在 624 个 ETF-日期中,有 34 个在某一侧没有挂牌的 15 delta 行权价。
- 训练截止日期。 Kronos 公布了截止日期(2024 年 6 月);TimesFM 和 Chronos-2 没有公布,但它们的训练数据清单里没有 A 股序列。在最后一个模型发布之后的日期上(2025 年 10 月起),没有一条简单规则、也没有一个未训练的模型通过标准;微调的 Chronos-2 在 1,000–2,000 步时处在边缘,从 4,000 步起明确通过。
- 只用了指数 K 线。 四个模型都只用指数 K 线训练。更多数据或其他输入,结果可能不同。
自己复现
本页没有可下载的脚本:期权价格来自不公开的每日历史隐含波动率曲面,微调也需要 GPU 和数小时计算。下面列出公开的输入和方法。
数据:
| 内容 | 来源 | 时间 |
|---|---|---|
| ETF 与指数日线 | 新浪,经 AKShare | 自各自上市起 |
| 用于微调的 515 个指数 | 新浪(上交所 / 深交所 / 中证)与申万(index_hist_sw),经 AKShare | 截至 2023-12-29 |
| 指数估值(市盈率、市净率、股息率) | 理杏仁(付费) | 2004 年起 |
| QVIX | AKShare | 2015-02 起 |
| 期权价格 | 每日隐含波动率曲面(2024 年起);重建的上交所期权链(2015–2024) | |
| 模型 | Kronos-small / -base、TimesFM 2.5、Chronos-2(公开权重) |
方法:
- 日期与目标。 周度测试日期为 2024-08-01 至 2026-08-25。目标 = 到下一个 ETF 到期日的对数收益的符号和大小(另有 5 个和 21 个交易日)。每次预测只用该日期及之前的数据。
- 简单规则。 20 日和 60 日动量、5 日收益的相反数,各自按近期波动率缩放;0.5 减去综合估值百分位。
- 模型。 每个模型根据过去 256 根 K 线(Kronos)或过去 512 个收盘价(TimesFM、Chronos-2)预测未来 30 个交易日。对 Kronos,P(上涨) = 64 条抽样路径中终点高于当日价格的比例;对 TimesFM 和 Chronos-2,则从它们的预测分位数读出。
- 残差 rank-IC。 在全部样本上把预测(其大小 ÷ 近期波动率)对四条简单规则做回归,保留残差,计算它与结果(收益 ÷ 近期波动率)的秩相关(Spearman)。95 % 区间来自按日历月的自助法。
- 价差。 每个日期,预测上涨就做牛市看涨价差,预测下跌就做熊市看跌价差:买入 30 delta 期权、卖出 15 delta 期权,持有到期。盈亏扣除完整的买卖价差和每张每腿 2 元,以 ETF 价格的 % 计。“方向价值” = 盈亏减去“永远做牛市价差”与“永远做熊市价差”的平均。
- 微调。 每个模型都从公开权重出发,使用 515 个指数截至 2023-12-29 的窗口(ETF 自己的指数以及相关性 ≥ 0.95 的指数除外)。Kronos-small 和 Kronos-base:256 天 K 线 + 30 天预测,分词器保持不变,只训练预测部分,学习率 4e-5。TimesFM 2.5 和 Chronos-2:512 个收盘价 + 30 天,用各自的训练损失训练全部权重,学习率分别为 1e-5 和 1e-6。批量 32 个窗口,在 0、250、500、1,000、2,000、4,000、8,000 和 16,000 步时用与零样本相同的测试打分,另加留出指数(2024 年 1–7 月),Kronos 模型还加 300 只股票(2025 年 12 月至 2026 年 9 月)。
- 事后检验。 按月打乱:把整月的预测随机重新分配 5,000 次,每次重新计算残差 rank-IC。时间平移:把预测沿日期平移 5 到 96 周的每一种偏移(首尾相接)。p 值 = 打乱后的结果中不低于真实结果的比例;Bonferroni = p × 37;Benjamini–Hochberg 校正作用于排序后的 37 个 p 值。