现在买指数 ETF 是不是太贵了?估值能告诉你什么,不能告诉你什么
数据:理杏仁的指数估值(市盈率 TTM、市净率、股息率),六个指数(上证50、沪深300、中证500、中证1000、创业板50、深证100),每日,2004-01 到 2026-11-02(较新的指数起始更晚);中证指数公司的全收益指数(上证50、沪深300、中证500、中证1000)和深证100 全收益指数(新浪),都通过 AKShare 获取;创业板50 由价格和股息率重建;10 年期国债收益率(AKShare)。以每月月末为起点。
对于“现在是不是长期买入指数的好时机”,估值大多给不出答案。在任何结果出来之前写定的规则下,只有一个指数以样本外也成立的方式通过,而它的 3 年通过很脆弱。5 年期限上没有任何通过。今天只有上证50 的市盈率显得偏贵,而且只是相对一个便宜的十年而言。
- 3 个中 0 个:在上证50、沪深300 和中证500 上,用过去数据拟合、再向前预测的模型,在每个指标、每个期限上都输给了简单的历史平均。六个指数合在一起,它的样本外 R² 在 3 年为 −0.55 到 −0.95,在 5 年为 −2.3 到 −5.3(5 年只算历史够长、有 5 年预测的四个指数;小于 0 = 比平均更差)。
- 5 年期限:没有任何通过:没有哪个指数、哪个指标通过。
- 深证100 的 3 年:市盈率、市净率和股息率通过,但很脆弱:用更多模拟次数、换五个随机种子重跑,只有 1 个种子通过。和它关系密切的沪深300(月收益相关系数 0.97)则什么也没有。
- 创业板50 的 3 年:股息率通过,依据是 42 个预测,约 1.2 个独立时段。同样脆弱。
- 8 对约 0.8:整个检验给出的通过数,对比“没有任何指标有预测力”时纯靠运气会出现的数目。比运气多,但几乎全部来自深证100,而它的估值序列还没有用第二个来源核对过。
- 11.8 和 86:上证50 今天的市盈率和它的 10 年百分位,也是唯一一个“偏贵”的读数。对比 2004 年以来的全部数据,它位于第 60 百分位,接近 2004 年以来的市盈率中位数 11.0。
- 每年 −3.3 % 到 +19.2 %:上证50 过去所有 5 年持有期年化收益的第 10 到第 90 百分位。每个指数的范围都这么宽,而估值并没有以样本外也成立的方式把它收窄。
- 事先定好:数据、指标、检验和通过规则都在计算任何未来收益之前写下并提交。
问题
你想买指数 ETF 并持有很多年。现在市场是不是太贵了,该不该等一等?本站的仪表盘把每个指数的估值显示为过去 10 年的百分位。本研究要问:这个读数,或者它背后的估值水平,对接下来 1、3、5 年有没有提供过有用的信息。
衡量“贵”的四种方法
- PE(price-to-earnings ratio,市盈率):指数价格除以成分公司过去 12 个月的盈利。市盈率 12 表示每 ¥1 的年盈利你付 ¥12。它的倒数 100 ÷ 市盈率就是盈利收益率(earnings yield,%):市盈率 12 对应盈利收益率 8.3 %。
- PB(price-to-book ratio,市净率):价格除以公司资产负债表上的净资产。
- dividend yield(股息率):过去 12 个月的分红占价格的百分比。越高越便宜。
- ERP(equity risk premium,股权风险溢价):盈利收益率减去 10 年期国债收益率,单位是百分点。它衡量股票比安全的国债多赚多少。越高,相对债券越便宜。
仪表盘把每个指标换算成 10 年百分位:0 = 过去 10 年最便宜的读数,100 = 最贵的。对股息率和股权风险溢价来说,“便宜”就是收益率高。本研究把 20 及以下算便宜,80 及以上算偏贵。
为什么“现在便宜,以后收益更高”是合理的想法
长期来看,指数的收益大约等于它的股息率,加上盈利的增长,再加上市场为每元盈利愿意付的价格的变化。如果你在低市盈率时买入,起点的盈利收益率和股息率就更高;如果市盈率之后回到通常水平,这个变化还会给你加一部分收益。如果在高市盈率时买入,回归就会把收益拿走。这就是所有“便宜时买入”规则背后的道理。
为什么在 A 股很难检验
- 独立时段很少。 这里最长的估值历史从 2004 年开始。22 年里只有大约四个互不重叠的 5 年时段。每月一个起点会得到 200 个数据点,但相邻月份的未来收益几乎完全相同,所以它们不是 200 次独立的检验。本研究计算 blocks(块数):预测数除以期限,大致等于一个结果背后的独立时段数。
- 一个大周期占了主导。 2007 年的顶、2008 年的底、2015 年的顶、2018 年的底和 2021 年的顶,几乎就是全部历史。一个规则只要拟合好这五个拐点,就会看起来很强,却仍然预测不了任何新的东西。
- 水平在漂移。 国债收益率从 4 % 以上降到 1.63 %,分红比例上升,创业板50 从极高的市盈率一路下调。2010 年的“便宜”水平,在 2026 年意思已经不一样。
我们怎么检验
out of sample(样本外)的含义,用平常的话说。 任何指标都可以在事后被拟合得很好。真正的问题是,它在当时能不能帮上忙。所以在每一个月,模型只用当时已经知道的结果来拟合,然后预测之后的 1、3 或 5 年,再和最简单的预测比较:当时已知的历史平均收益。评分是样本外 R²(R²_OS):大于 0 = 估值预测比平均更准,小于 0 = 更差。符号拟合反了的(例如“便宜 → 收益更低”)就用平均代替;这叫 Campbell–Thompson 规则(图中的“CT rule”)。
- 指数: 上证50、沪深300、中证500、深证100(历史长,始于 2004–2007 年),以及中证1000、创业板50(始于 2014 年)。这就是仪表盘上的六个指数。
- 收益: total return(TR,全收益),即分红再投资后的收益,取自官方全收益指数;创业板50 没有全收益指数,所以用它的价格和股息率重建(每年约高估 0.1–0.2 个百分点)。ETF 持有人拿到的是这个收益减去基金费用(每年 0.15–0.5 %)和跟踪误差。所有收益都按每年 % 显示。
- 时点一致。 每个日期的 10 年百分位只用该日期之前的 10 年数据,从不使用之后的数据。(仪表盘自己的窗口以今天为锚,所以它在过去某天的百分位会用到未来数据;本研究不会。)
- 一个指标对某个指数、某个期限“成立”,必须三项全部通过:
- 样本内:在全部历史上,斜率符号符合预期,并且经得起两种校正:一是月度收益互相重叠(Hodrick 标准误,|t| ≥ 1.96),二是同时检验四个指标(Holm 方法,5 % 水平,基于一个模拟:它去掉了持续性强的预测变量在短样本中造成的偏差);
- 样本外:R²_OS 大于 0,并且单侧 Clark–West 检验小于 5 %;
- 稳定:依次去掉五个大拐点中的每一个,以及分成前后两半(2015 年之前 / 之后),斜率符号都不变。 只通过一部分 →“有迹象”(suggestive)。否则为“否”。
- 要成为本站的信号,同一指标需要在 3 或 5 年期限上,在 4 个历史较长的指数中至少 3 个上成立,并且所有指数合并的 R² 为正。
数据、指标、检验和通过规则都在计算任何未来收益之前写下并提交。本页其他内容都在第一次运行之后才加入,并且都有标注:一个修正(让任何收益都不在不完整的最后一个月结束;它改变了四个格子,其中包括全部四个 3 年的通过)、换种子重跑、深证100 从 2006-02 起的重跑、运气计数,以及百分位检验。
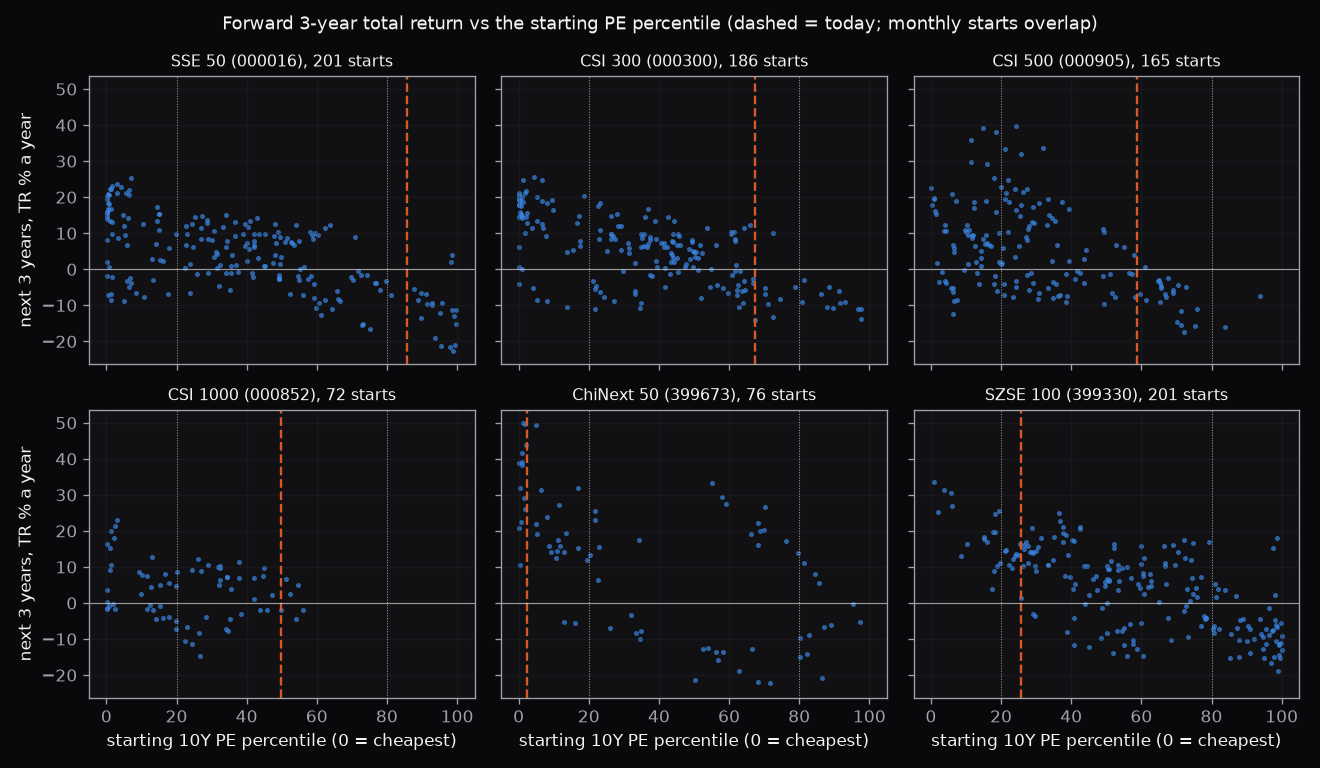
每个月末起点之后 3 年的全收益,对比起点的 10 年市盈率百分位。向下的斜率是真实的,但它来自少数几段互相重叠的长串起点。
结果
每个指数、每个期限的结论(每格四个指标:市盈率、市净率、股息率、股权风险溢价):
| 指数 | 1 年 | 3 年 | 5 年 |
|---|---|---|---|
| 上证50 | 无 | 无 | 无 |
| 沪深300 | 无 | 无 | 无 |
| 中证500 | 无 | 无 | 无 |
| 中证1000 | 市净率有迹象 | 市盈率、市净率有迹象(1 块) | 无法检验 |
| 创业板50 | 无 | 股息率成立,脆弱(1.2 块);市净率有迹象(1 块) | 无法检验 |
| 深证100 | 四个全部成立(从 2006-02 起则不成立) | 市盈率、市净率、股息率成立,脆弱;股权风险溢价有迹象 | 股息率有迹象(1 块) |
在检验的 72 个格子(6 个指数 × 4 个指标 × 3 个期限)中,8 个成立,6 个有迹象;其中 64 个可以做样本外检验。中证1000 和创业板50 从 2014 年开始,所以还没有 5 年预测。
- 上证50、沪深300 和中证500:否。 拟合的模型在样本外的每个指标、每个期限上都输给了简单平均。对买这些指数的人来说,估值没有把接下来 3–5 年预测得足够好,不能用来择时买入。
- 深证100 的 3 年:脆弱的通过。 它的样本外预测在四个指标上都胜过平均(R²_OS +0.06 到 +0.46),而且只用 2006-02 起(指数首次发布之后)的起点时依然如此(+0.31 到 +0.51)。但样本内这一步在事先定好的抽样上(2,000 条模拟路径,种子 0)只以 0.001 的差距通过 Holm 校正。用种子 0–4 重跑,它在 2 个种子上四个指标全部通过,在 1 个种子上通过三个,在 2 个种子上一个也没通过;用 20,000 次抽样时,5 个种子中只有 1 个通过。从 2006-02 起,这一步不通过。
- 深证100 的 1 年:四个指标在每个种子上都通过,但只用 2006-02 起的起点时不通过(R²_OS −0.30 到 −0.78)。这个通过依赖 2004–2005 年的起点,那时这个指数还不存在。
- 创业板50,3 年的股息率:样本内在每个种子上都通过,但样本外 R²_OS 只有 +0.02,依据是 42 个预测(1.2 块)。去掉在不完整最后一个月结束的那一个预测,它就从 −0.35 变成了这个数。
- 为什么是深证100 而不是沪深300? 两个指数的月收益相关系数为 0.97,却只有深证100 的估值有预测力。这更像是它的估值序列(如何加权,或者 2006 年之前如何回填)的特点,而不是市场的特点。在任何人据此下结论之前,需要用第二个来源核对,例如深交所公布的市盈率。
这里面有多少是运气?
有 72 个格子,即使没有任何指标有预测力,也会冒出几个通过。为了数清楚,我们在模拟数据上把整个检验跑了 500 次,模拟中估值和之后的收益没有任何关系(每个指标保留自己的持续性,同一指数的四个指标保留它们之间的相关性):
| 计数 | 实际 | 运气:平均 | 运气:第 90 百分位 | 运气达到或超过实际的比例 |
|---|---|---|---|---|
| 通过数,所有期限 | 8 | 0.84 | 3 | 0.8 % |
| 3 年和 5 年的通过数 | 4 | 0.59 | 2 | 3.6 % |
| 有通过的“指数 × 期限”组 | 3 | 0.57 | 2 | 2.4 % |
所以这比纯粹的运气要多。但模拟把六个指数当成互相独立,而真实的指数会一起涨跌,所以通过会比这里更常扎堆出现;上面的比例偏低。而且这些通过几乎全在一个指数上,即深证100,它的数据正是还没解决的问题。
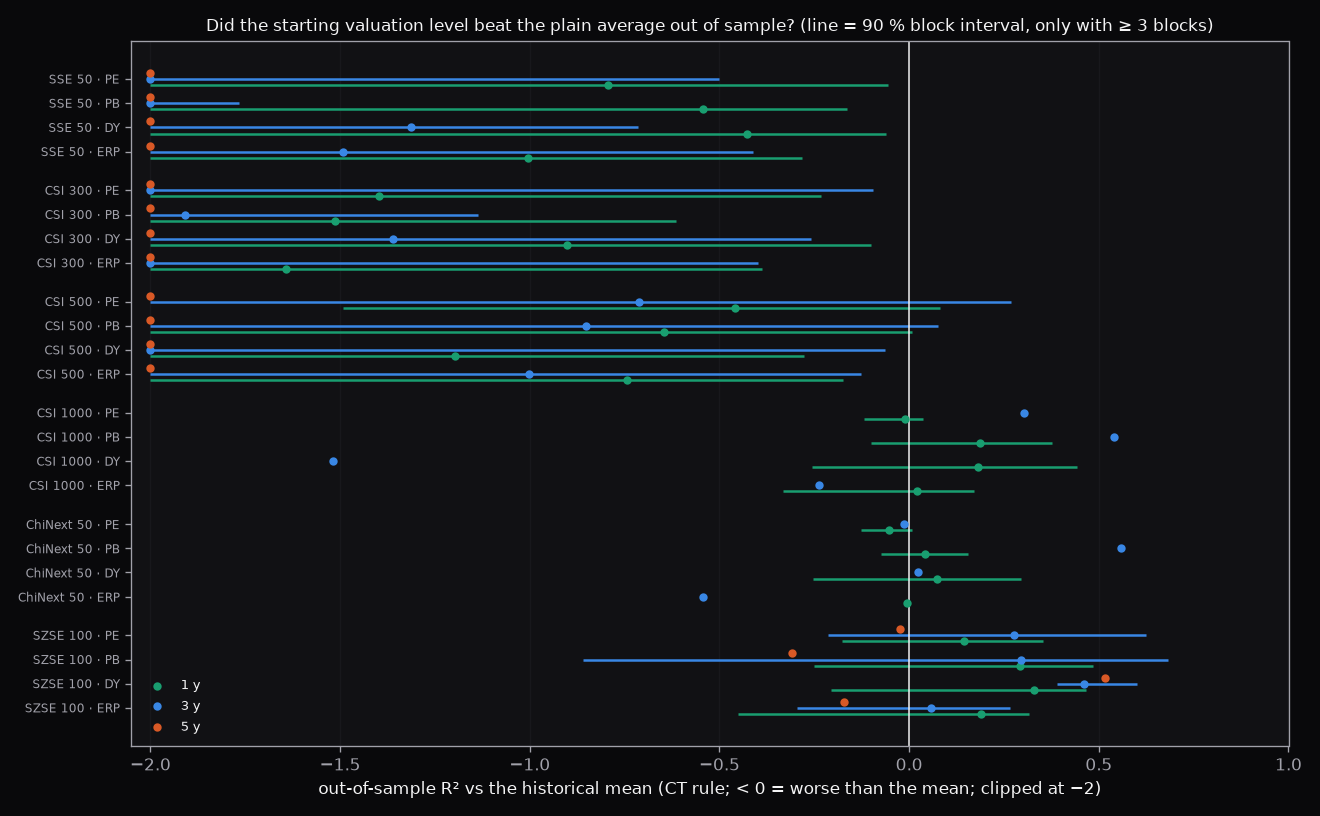
起点估值在样本外胜过简单平均了吗?在竖线左边 = 比平均更差。
今天,逐个指数看
读数日期为 2026-11-02。百分位是仪表盘的 10 年百分位,按时点一致的方法计算(0 = 最便宜,100 = 最贵;对股息率和股权风险溢价,收益率高就读作便宜)。收益范围是过去每一个月末起点在之后 5 年的结果,每年 %:第 10 / 50 / 90 百分位。它不是预测。
| 指数 | 今天的市盈率 | 10 年百分位:市盈率 / 市净率 / 股息率 / 股权风险溢价 | 过去 5 年收益,每年 %(第 10 / 50 / 90 百分位) |
|---|---|---|---|
| 上证50 | 11.8 | 86 偏贵 / 48 / 63 / 54 | −3.3 / +5.8 / +19.2 |
| 沪深300 | 13.5 | 67 / 21 / 31 / 30 | −2.7 / +4.7 / +15.1 |
| 中证500 | 27.3 | 59 / 55 / 33 / 18 便宜 | −1.9 / +3.9 / +13.1 |
| 中证1000 | 37.7 | 50 / 12 / 16 / 8(三项便宜) | −4.7 / −0.3 / +5.1(只有 2014–21 年的起点;不能据此做计划) |
| 创业板50 | 22.7 | 2 / 14 / 7 / 0(四项便宜) | −1.1 / +6.9 / +11.9(只有 2014–21 年的起点;不能据此做计划) |
| 深证100 | 21.0 | 26 / 14 / 12 / 8(三项便宜) | −2.7 / +6.2 / +28.3 |
- 只有上证50 的市盈率显得偏贵,而且是相对一个便宜的十年。 它 11.8 的市盈率在 10 年窗口里位于 86,这个窗口的范围是 8.3–15.1。对比 2004 年以来的全部读数,它位于第 60 百分位,接近 2004 年以来的市盈率中位数 11.0。它的市净率、股息率和股权风险溢价都在中间。
- 沪深300 和中证500 在每个指标上都在中间(中证500 的股权风险溢价为 18)。
- 中证1000、创业板50 和深证100 在市净率、股息率和股权风险溢价上显得便宜(创业板50 的市盈率为 2)。这种“便宜”有一部分来自漂移,而不是捡到便宜货:10 年期国债收益率为 1.63 %,处在样本的最低点(月末值 1.62–4.55 %),这抬高了每一个股权风险溢价;分红比例上升,抬高了股息率;创业板50 从极高的市盈率一路下调(它的 10 年市盈率范围是 20.6–106.7)。
- 中证1000 和创业板50 只有 2014 到 2021 年起点的 5 年结果,大约 1½ 个独立时段。表中列出了它们的范围,但不能据此做计划。
- 3 年的范围更宽:六个指数的第 10 百分位在每年 −7.7 到 −18.2 % 之间。
上证50 偏贵的市盈率,在历史上意味着什么。 过去市盈率百分位与今天相差 10 点以内的 3 年起点,年化收益中位数为 −7.8 %,但只来自 2 个独立时段,而且把 2007 年的起点(市盈率 32–41)和 2020–21 年的起点(市盈率 11–12)混在一起。2007 年顶部 35 倍的市盈率和今天 11.8 倍的市盈率,共享的是百分位,而不是价格,所以这对今天说明不了多少。
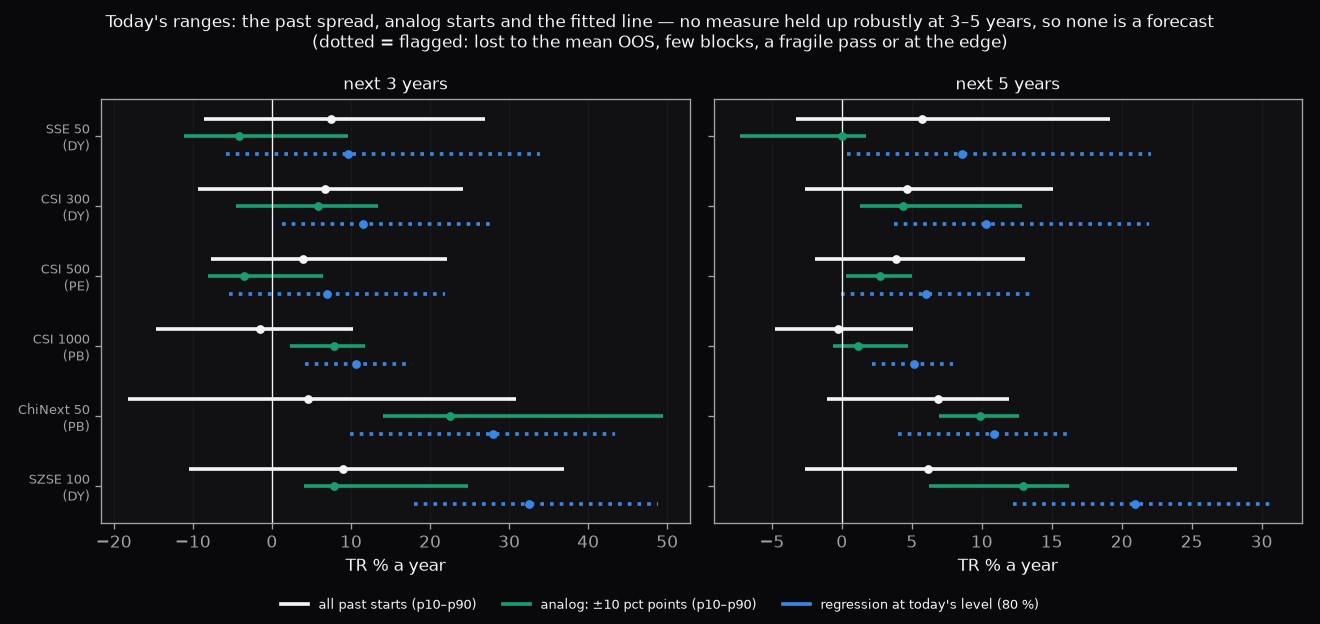
每个指数今天的范围:所有过去起点的收益、估值相似的起点的收益,以及一条拟合线给出的数。没有一条拟合线算得上预测。
历史确实显示了什么
按时点一致的 10 年百分位分组,过去看起来像教科书说的那样,只是行情次数非常少:
- 便宜区间(20 及以下),大盘指数,5 年:上证50 和沪深300 的起点每年赚约 +10 %,没有一个亏钱。这只依据 2–3 个独立时段,所以本研究把这些 5 年分组标为“不可靠”。
- 偏贵区间(80 及以上),3 年:起点每年亏 9–14 %,其中 85–100 % 亏钱。这只有 1–2 个时段:2007 年和 2021 年的顶部。
- 用百分位本身做预测。 看到第一次运行的结果之后,我们又试了用 10 年百分位本身做样本外预测。所有指数合在一起,它在 3 年胜过了平均(R²_OS +0.13 到 +0.35)。但这是靠上证50 和深证100 撑起来的:中证500 在四个指标上都为负,沪深300 有两个为负,中证1000 和创业板50 只多出 1–5 个预测。它依赖一个周期(2015 年的顶、2018 年的底、2021 年的顶),而且是看到数据之后才选的,所以它是一个需要向前检验的假设,不是规则。从 2023-11 起的预测从 2026-11 开始陆续到期;一个全新的 36 个月块在 2029-10 完整。
- 国债收益率几乎没有增加信息。 与盈利收益率一起放进模型时,10 年期收益率的斜率正负都有,Hodrick |t| 在每个指数、每个期限上都低于 1.96,只有深证100 的 1 年例外。
关于估值和短期尾部波动(21 天到 3 个月),见外部数据能不能帮助从好交易中挑选:同样的估值数据,同样的答案。
这对你意味着什么
- 按各自的历史,没有一个指数显得“太贵”,只有上证50 在 10 年市盈率窗口上例外,而那个窗口覆盖的是一个便宜的十年。
- 估值能预测之后 3–5 年的证据太薄、太脆弱,不能用来择时买入。 按完整的范围做计划:在历史较长的指数上,过去每一个 5 年窗口,不论起点估值如何,第 10 百分位是每年亏约 2–3 %,第 90 百分位是每年赚 13–28 %。
- 本站不做任何改动。 仪表盘继续把 10 年百分位当作“价格处在什么位置”的描述来显示,而不是信号。本研究自己定的信号门槛(同一指标在 4 个历史较长的指数中至少 3 个上成立)没有任何指标达到。
- 什么时候再看:下一批 3 年窗口到期时(2026-11 起),只用新的预测重跑百分位检验;以及深证100 的估值序列用第二个来源核对之后。
这项研究不能说明什么
- 估值从来不重要。 检验的力度很小:每个指数大约只有四个 5 年时段,而且水平在漂移(分红、国债收益率、创业板50 的估值下调),这会削弱固定水平的回归。一个中等大小的真实效应可能被漏掉。百分位的结果是值得关注的候选。
- 为什么深证100 和沪深300 不同。 这可能是它的估值序列的特点,而不是市场的特点。在核对之前,它的结果不应用于任何事情。
- 1 年的择时。 只有深证100 在 1 年通过,而且只靠它 2004–2005 年的起点。
- 利率的故事。 今天的国债收益率(1.63 %)处在样本最低点,所以今天任何股权风险溢价的读数都是外推。
- 2014 年起的指数。 中证1000 和创业板50 大约只有一个 3 年预测块,没有 5 年预测。它们“便宜”的读数依据的是一个下跌市场中的 10 年历史。
- 怎么买。 一次性买入还是分批买入、费用、税、跟踪误差和买入顺序都没有检验,盈利增长、资金流向和政策也没有。10 年平均盈利的市盈率(CAPE)只做了描述:它从 2014 年才有,太短,无法检验 5 年。
- 是指数,不是 ETF。 用的是全收益指数,不是 ETF 价格;ETF 持有人大约少赚基金费用那么多。
自己复现
本页没有可下载的脚本:估值历史来自付费数据(理杏仁)。其他输入都是公开的。完整的方法如下;用同样的估值历史,可以复现本页的表格。
数据:
| 内容 | 来源 | 起始 |
|---|---|---|
| 指数市盈率(TTM)、市净率、股息率(市值加权),每日 | 理杏仁(付费) | 上证50 和深证100 2004-01-02,沪深300 2005-04-08,中证500 2007-01-15,创业板50 2014-06-18,中证1000 2014-10-17 |
| 全收益指数 H00016、H00300、H00905、H00852 | 中证指数公司,AKShare stock_zh_index_hist_csindex | 各自的基日(去掉基日之前恒为 1000.0 的行) |
| 深证100 全收益 399004 | 新浪,AKShare stock_zh_index_daily | 2003 |
| 指数价格收盘价 | 新浪,AKShare stock_zh_index_daily | 各自上市起 |
| 10 年期国债收益率 | AKShare bond_zh_us_rate | 2002 |
创业板50 没有全收益序列。用价格 P 和股息率 DY(%)重建:
TR[t] = TR[t-1] * (P[t] / P[t-1]) * (1 + DY[t-1] / 100 * calendar_days / 365)
在有官方全收益序列的五个指数上,这个方法每年偏差 −0.52 到 +0.02 个百分点;对创业板50,它每年约高估 0.1–0.2 个百分点。
方法:
- 月度面板。 对每个指数、每个日历月:有估值数据的最后一天,以及该日或之前的全收益水平。国债收益率取该日或之前的最后一个,最多 7 个日历日之前,否则股权风险溢价记为缺失。
- 指标。 盈利收益率 EY = 100 ÷ 市盈率;log 市净率;股息率 DY(%);股权风险溢价 ERP = EY − 国债收益率。斜率的预期符号:EY、DY 和 ERP 为 +,log 市净率为 −。
- 10 年百分位,时点一致。 在第 t 天:截至 t 的 3,650 个日历日内,每日“贵度”值(市盈率、市净率、−DY、−ERP)中小于或等于当天值的比例;至少 750 行,否则记为缺失。从不使用 t 之后的数据。便宜 ≤ 20,偏贵 ≥ 80。
- 结果。 y(t, h) = log TR(t + h) − log TR(t),h = 12、36、60 个月,只取结束月份完整的;显示为年化。
- 样本内。 在所有月度起点上用 OLS 把 y 对指标回归。Hodrick(1992)标准误(同时给出 h 阶滞后的 Newey–West)。“没有预测力”的零假设用模拟:一个月收益与预测变量的 AR(1) 冲击一起抽取(ρ 做小样本偏差校正,最多 0.995),2,000 条路径,种子 0;单侧 p。对同一指数、同一期限的四个指标做 5 % 的 Holm 校正。
- 样本外。 在每个月 t,用 s + h ≤ t 的数据对(只用 t 时已知的结果)拟合,至少 36 对;预测 â + b̂ × x(t);基准是同样这些已知结果的平均。b̂ 符号反了 → 用平均(Campbell–Thompson)。R²_OS = 1 − Σ(y − 预测)² ÷ Σ(y − 平均)²。单侧 Clark–West,h 阶滞后的 Newey–West。90 % 区间来自移动块 bootstrap(每块 h 个月,2,000 次抽样),只在至少 3 块(预测数 ÷ h)时显示。
- 稳定。 在全样本拟合中,以及依次去掉 2007-10、2008-10、2015-06、2018-12、2021-02 各自前后 12 个月内的所有起点,再加上 2015-01 之前 / 之后两半(不足 24 个起点的一半跳过),斜率都保持预期符号。
- 结论。 成立 = 第 5 步(符号、Hodrick |t| ≥ 1.96、Holm)、第 6 步(R²_OS > 0、Clark–West p < 0.05)和第 7 步全部通过。只通过一部分 = 有迹象。
第一次运行之后加入的检查:
- 脆弱:每个通过都用 20,000 条模拟路径、种子 0–4 重跑;Holm 在 5 个种子中少于 3 个通过,或样本外少于 3 块,即为脆弱。
- 运气计数:在 500 次模拟上跑整个检验,收益从真实月份中抽取、与指标没有关系(每个指标是 AR(1),用校正后的 ρ;同一指数的四个指标共用同样的月份抽样),每格 200 条模拟路径。
- 深证100 从 2006-02 起:深证100 的每个格子只用 2006-02 起的起点重跑,即它的价格指数首次发布(2006-01-24)之后。
- 百分位做预测变量:第 6 步,x(t) = −(10 年百分位)。