时间序列模型能比市场的波动率预测更准吗?
数据:六只有上市期权的 exchange-traded fund(ETF,交易所交易基金):50ETF、300ETF、500ETF、创业板ETF、科创50ETF、深100ETF。点预测:135 个日期上的 387 个互不重叠的 30 天窗口,2015-05-11 至 2026-08-10。区间预测:每周一个预测日,2015–2026 年,主结果从 2024 年 7 月起。来源:新浪日线价格(收盘价;基于价格区间的波动率另用开盘、最高、最低价)和 QVIX 隐含波动率指数,均通过 AKShare 获取。
不能。 App 对下个月 realised volatility(RV,已实现波动率)的预测,是市场的 implied volatility(IV,隐含波动率)减去一个小的长期溢价。八个标准时间序列模型没有一个单独使用时能胜过它,基础模型也不能。预测结果的区间时,以 IV − 溢价为中心、用它自身实测误差决定宽度的区间是诚实的,App 的 Kelly 仓位现在用的就是这个区间。
- 8 个里 0 个时间序列模型单独胜过 IV − 溢价;8 个里 6 个明显更差。
- ≤ 2 %:把模型和它组合的最大改善,不显著。只对 IV 拟合一个斜率就能做到同样效果。
- 2.0 倍:波动率飙升之后,最简单的模型(EWMA)的误差相对 IV − 溢价的倍数。
- 76–83 %:2024 年 7 月以来,IV − 溢价的 80 % 区间接住结果的比例(1 周、到下一个到期日、1 个月三个期限)。
问题是什么
波动率溢价研究发现,预测未来 30 天已实现波动率最好的简单方法,是 IV 减去长期溢价;知道 IV 之后,近期已实现波动率的平均值不再提供任何信息。但近期已实现波动率是最粗糙的时间序列预测。正规的模型会更重视近期的波动、捕捉 mean reversion(均值回归),并区分下跌和上涨。它们是否知道 IV 不知道的东西?
| 模型 | 做什么 |
|---|---|
| EWMA | Exponentially weighted moving average(指数加权移动平均):每日涨跌平方的加权平均(λ = 0.94),越近的日子权重越大。 |
| GARCH(1,1) | Generalised autoregressive conditional heteroskedasticity(广义自回归条件异方差):今天的波动率取决于昨天的涨跌和昨天的波动率,并会回到一个长期水平。 |
| GJR-GARCH | 下跌比上涨更能推高波动率的 GARCH(leverage effect,杠杆效应)。 |
| EGARCH | Exponential GARCH(指数 GARCH):对 log 波动率建模,带自己的非对称项。 |
| GARCH-t | 每日涨跌服从 fat-tailed(厚尾)Student-t 分布的 GARCH。 |
| HAR-RV | Heterogeneous autoregressive model of realised volatility(已实现波动率的异质自回归模型):用过去一天、一周、一个月的已实现波动率做回归,是标准基准。 |
| log-HAR | 取 log 的 HAR,能缓和飙升的影响。 |
| HAR-RV-IV | 加入隐含波动率作为输入的 HAR。 |
设定。 目标、样本和日期都与波动率溢价研究相同:每只 ETF 大约每 30 天一个样本,目标是随后 30 个自然日的已实现波动率,所以任意两个窗口都不重叠。IV 用公开的 QVIX 指数(类似 VIX 的 30 天隐含波动率)。每个模型在每个日期都只用当天已有的数据重新拟合:GARCH 用截至当天的全部收益,HAR 只用已经结束的 30 天窗口。IV − 溢价减去的是当天之前所有已结束窗口的平均溢价(IV 减随后的已实现波动率),所以它同样看不到未来。
在 QVIX 上这个溢价约为 2.6–2.9 个 vol point(波动率点);QVIX 包含 skew(波动率偏斜),比 at-the-money(ATM,平值)IV 高 1–3 点。换成 App 从期权链读取的平值 IV,同样的思路得到 ATM IV − 1 点,这是本研究进行时 App 的预测。自 2026 年 10 月起,App 改用 0.95 × ATM IV:溢价随 IV 增大(见后续研究)。
有没有模型单独就能胜过 IV − 溢价?
指标是 root mean square error(RMSE,均方根误差),单位 vol point(1 点 = 0.01 年化波动率),样本为 2019–2026 年 87 个日期上所有预测都齐全的 339 个样本。“相对 IV − 溢价”是 RMSE 之比:低于 1 更好。Diebold–Mariano(DM)t 逐日比较两个预测的平方误差:t > 0 表示 IV − 溢价更好;单次检验通常要 |t| 超过约 2 才算显著。
| 预测 | RMSE | 相对 IV − 溢价 | DM t |
|---|---|---|---|
| IV − 溢价 | 9.78 | 1.000 | — |
| 近期已实现波动率(30/60/90 天平均) | 10.88 | 1.112 | +2.81 |
| QVIX 原值 | 10.05 | 1.028 | +1.38 |
| a + b·IV,拟合斜率(对照组) | 9.60 | 0.982 | −0.78 |
| EWMA | 11.59 | 1.185 | +2.58 |
| GARCH(1,1) | 11.39 | 1.165 | +2.63 |
| GJR-GARCH | 11.37 | 1.162 | +2.57 |
| EGARCH | 10.40 | 1.063 | +2.09 |
| GARCH-t | 11.12 | 1.136 | +3.30 |
| HAR-RV | 11.10 | 1.135 | +2.89 |
| log-HAR | 10.20 | 1.043 | +1.27 |
| HAR-RV-IV | 10.01 | 1.023 | +1.35 |
| GARCH(1,1),去偏 | 11.08 | 1.133 | +2.11 |
| EGARCH,去偏(最好的模型) | 9.84 | 1.006 | +0.66 |
- 只用历史价格的模型全部差 2–19 %,八个中有六个明显更差(t 2.1–3.3)。
- 原始的 GARCH 和 HAR 预测平均高出 3–4 点:它们会回归到一个包含 2008 和 2015 年股灾的长期水平。在样本外去掉这个 bias(偏差)后有所改善,最好的 EGARCH 追平了 IV − 溢价(1.006),但没有超过;把日期网格平移 0 到 20 个交易日得到 21 个版本,它只赢了 9 个。
- 唯一低于 1 的一行完全不用时间序列模型:a + b·IV,对 IV 拟合一个截距和斜率(0.982)。
模型能提供 IV 不知道的信息吗?
把下个月的已实现波动率同时对 IV 和一个模型做回归:RV = a + b·IV + c·model。如果模型有 IV 没有的信息,c 会明显大于零。
- 全部不通过。 一共做了 32 个回归(8 个模型、两种 IV、水平值和 log),结果需要 |t| 约 3.2 才算数。最大的是 2.38(HAR-RV,且只在一种设定下);换成原始 IV 降到 1.69,取 log 后降到 0.97。
- 最好的模型只把下个月波动率被解释的比例从 36.5 % 提高到 38.0 %。
- 把这些回归当作预测使用,最多比 IV − 溢价好 2 %。但只用 a + b·IV 就能好 1.8 %,而且没有任何带模型的回归胜过这个对照组。
波动率飙升之后,模型错得很厉害
这里的“飙升月份”指近期已实现波动率比 IV 高出 3 点以上(13 个日期、29 个样本)。
- 只用收益数据的模型,误差都是 IV − 溢价的 1.3–2.0 倍:EWMA 2.04 倍,GARCH-t 1.82 倍,GARCH 1.80 倍,GJR 1.79 倍,HAR 1.68 倍,EGARCH 1.47 倍,log-HAR 1.34 倍(DM t 2.4–3.6,log-HAR 为 1.45)。近期已实现波动率:1.83 倍。
- GARCH 和 HAR 会把飙升延续下去,而市场的 IV 已经计入了它的回落。只有包含 IV 的预测在飙升后仍接近 1。
- 在其他所有测试过的环境里(平静月份、已实现波动率最高的 10 %、IV 偏贵或偏便宜、跨越长假的窗口),都和 IV − 溢价没有可区分的差异。每组只有 13–44 个日期。
值得做一个混合预测吗?
混合 w·(IV − 溢价) + (1 − w)·model,并拟合权重 w。
| 模型 | IV − 溢价的权重 | 95 % 区间 | 前半段 / 后半段 |
|---|---|---|---|
| HAR-RV | 0.75 | 0.58 – 0.94 | 0.77 / 0.74 |
| EGARCH | 0.66 | 0.38 – 0.98 | 0.90 / 0.54 |
| log-HAR | 0.61 | 0.43 – 1.01 | 0.69 / 0.60 |
| GARCH(1,1) | 0.90 | 0.59 – 1.13 | 0.84 / 0.92 |
| EWMA | 1.07 | 0.75 – 1.47 | 0.83 / 1.12 |
混合只改善约 1 %(0.7–1.4 %),不显著,而且权重在历史前后两半之间漂移(EGARCH 0.90 → 0.54)。做一个混合预测,意味着每天要为每个标的拟合一个 GARCH 或 HAR 模型,换来的只是噪声级别的改善。
基础模型:TimesFM 和 Kronos
Foundation model(基础模型)是在大量时间序列上预训练的大型神经网络,这里以 zero-shot(零样本、不做微调)方式使用。Google 的 TimesFM 2.5(2 亿参数)预测单个序列,输入分别是每日收益平方、已实现波动率序列,或已实现波动率加 IV。Kronos 在 45 个以上交易所的 K 线数据上训练,每个日期生成 32 条可能的未来 K 线路径,再取每条路径已实现波动率的平均。
Pretraining leakage(预训练数据泄漏)。 如果模型训练时见过测试月份,就等于提前看过答案。Kronos 的训练数据包含上交所和深交所到 2024 年 6 月的 ETF 行情,所以主结果只计 2024 年 7 月之后的预测日期:25 个日期、150 个样本。TimesFM 公布的训练数据不含 A 股。
| 预测(2024 年 7 月起) | RMSE | 相对 IV − 溢价 | DM t |
|---|---|---|---|
| IV − 溢价 | 12.90 | 1.000 | — |
| a + b·IV(对照组) | 12.63 | 0.979 | −0.57 |
| EGARCH,去偏 | 12.69 | 0.984 | −0.31 |
| GARCH(1,1) / HAR-RV | 14.81 / 14.17 | 1.148 / 1.098 | +1.60 / +1.89 |
| TimesFM,输入收益平方 | 12.03 | 0.933 | −1.66 |
| TimesFM,输入已实现波动率序列 | 12.70 | 0.985 | −0.32 |
| TimesFM,已实现波动率 + IV | 13.15 | 1.019 | +0.47 |
| Kronos-small | 23.61 | 1.830 | +2.61 |
| Kronos-base | 30.29 | 2.348 | +1.66 |
- 输入收益平方的 TimesFM,是这几项研究里第一个不比 IV − 溢价差的预测:2024 年 7 月以来误差低 7 %,全部历史上低 4.5 %(87 个日期,比值 0.955)。测试了 7 种变体,结果需要 |t| 约 2.7 才算数,它只有 1.66,所以不显著。
- 它的平均优势来自高波动的年份(2020 年 0.90,2025 年 0.88),在平静年份反而更差(2019 年 1.49,2023 年 1.29)。飙升之后它不会把飙升延续下去:误差是 IV − 溢价的 0.84–0.89,而 GARCH 是 1.81。
- 对比简单的 a + b·IV 对照组,全部历史上的优势消失(t +0.02);混合权重在前后两半之间漂移,正是排除经典模型混合的同一种不稳定。
- Kronos 差得很远。 它生成的路径波动太大(small:平均预测 28.4,实际 20.7;base:38.9 对 24.8),在它训练过的月份也一样,而且模型越大越差。它的价格 token 对 ETF 的日度波动来说可能太粗。
80 % 区间真的有 80 % 命中吗?
用 Kelly criterion(凯利公式)定仓位,需要的是结果的分布,而不是一个数。所以研究还在每周的预测日上,预测三个期限(1 周、到下一个月度到期日、1 个月)已实现波动率的完整区间,并检查区间是否诚实,即是否 calibrated(校准良好):80 % 区间应该有 80 % 的时候包含实际结果,每个 5 % 的尾部应该只有 5 % 的时候被击中。
基准(B1)是以 IV − 溢价为中心的对数正态区间:中间值是 IV − 溢价(按过去对数误差的平均略作调整),宽度是它自己过去对数误差的离散度,两者都只用已结束的窗口。对手是四个零样本运行的基础模型(TimesFM 2.5 和 3.0、Amazon 的 Chronos-Bolt 和 Chronos-2),每个分别输入每日收益平方,或由每日开盘、最高、最低、收盘价算出的 range-based volatility(基于价格区间的波动率)(Garman–Klass–Yang–Zhang 估计量,噪声小得多)。每个模型还有一个 recalibrated(再校准)版本:用它自己过去的失误把区间放宽或收窄。
整个分布的得分用 CRPS(continuous ranked probability score,连续分级概率评分),相对基准:低于 1 更好。到下一个到期日,2024 年 7 月起(666 个预测,27 个到期日):
| 分布 | 50 % | 80 % | 90 % | 判定 | CRPS 相对 B1 |
|---|---|---|---|---|---|
| B1:IV − 溢价,对数正态 | 0.47 | 0.76 | 0.87 | 校准良好 | 1.000 |
| B1,宽度随到期天数收窄 | 0.46 | 0.77 | 0.87 | 校准良好 | 0.994 |
| B2:a + b·IV,对数正态 | 0.45 | 0.76 | 0.86 | 校准良好 | 0.999 |
| B3:IV − 溢价 × 过去的实际误差 | 0.38 | 0.70 | 0.86 | 太窄 | 1.000 |
| TimesFM 2.5,range 输入,再校准 | 0.43 | 0.74 | 0.85 | 校准良好 | 1.035 |
| Chronos-2,range 输入,再校准 | 0.46 | 0.76 | 0.88 | 校准良好 | 1.039 |
| Chronos-2,range 输入,原始 | 0.34 | 0.59 | 0.73 | 太窄 | 1.049 |
| TimesFM 2.5,收益平方,原始 | 0.42 | 0.70 | 0.83 | 太窄 | 1.077 |
| Chronos-Bolt,收益平方,原始 | 0.35 | 0.66 | 0.79 | 太窄 | 1.287 |
50 / 80 / 90 % 三列是实际结果落在对应中间区间内的比例(理想值 0.50 / 0.80 / 0.90)。
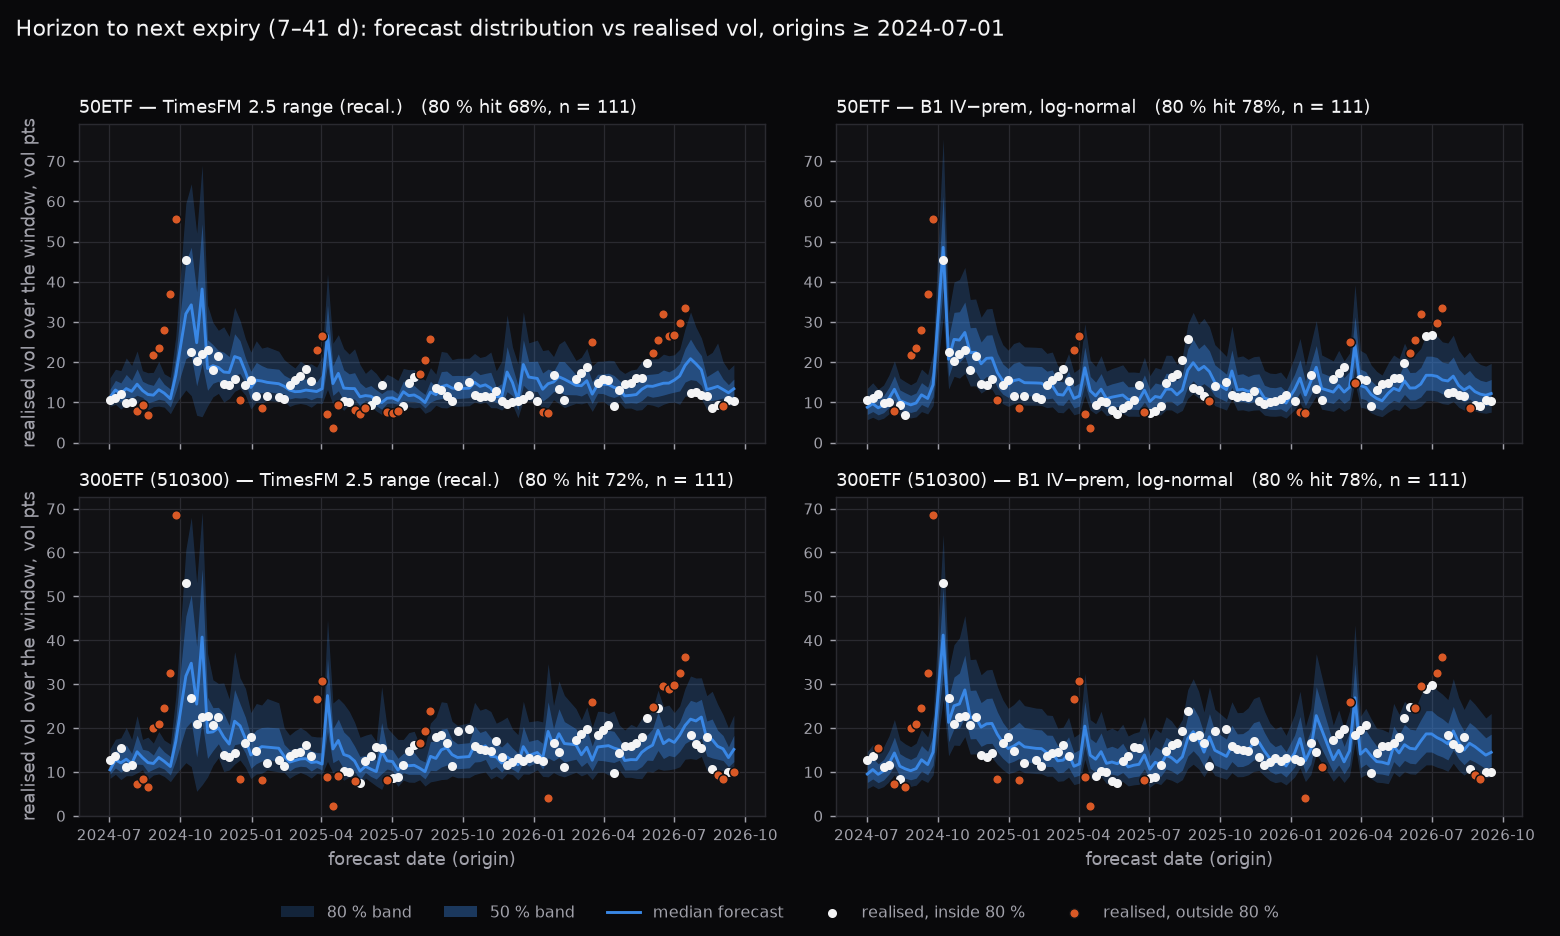
到下一个到期日的预测区间与实际已实现波动率,50ETF 和 300ETF,2024 年 7 月起。左:最佳基础模型;右:IV − 溢价(图中标为 B1)。
按期限(2024 年 7 月起):
| 期限 | B1 落在 50 / 80 / 90 % 内 | B1 判定 | 最佳基础模型,CRPS 相对 B1 | 原始模型落在 80 % 内 |
|---|---|---|---|---|
| 1 周(660 个预测,110 个日期) | 0.49 / 0.82 / 0.90 | 校准良好 | 0.990(t −0.39) | 0.48–0.77 |
| 到下一个到期日(666 个,27 个到期日) | 0.47 / 0.76 / 0.87 | 校准良好 | 1.035(t +0.95) | 0.57–0.71 |
| 1 个月(150 个,25 个日期) | 0.46 / 0.83 / 0.87 | 校准良好 | 1.012(t +0.18) | 0.57–0.70 |
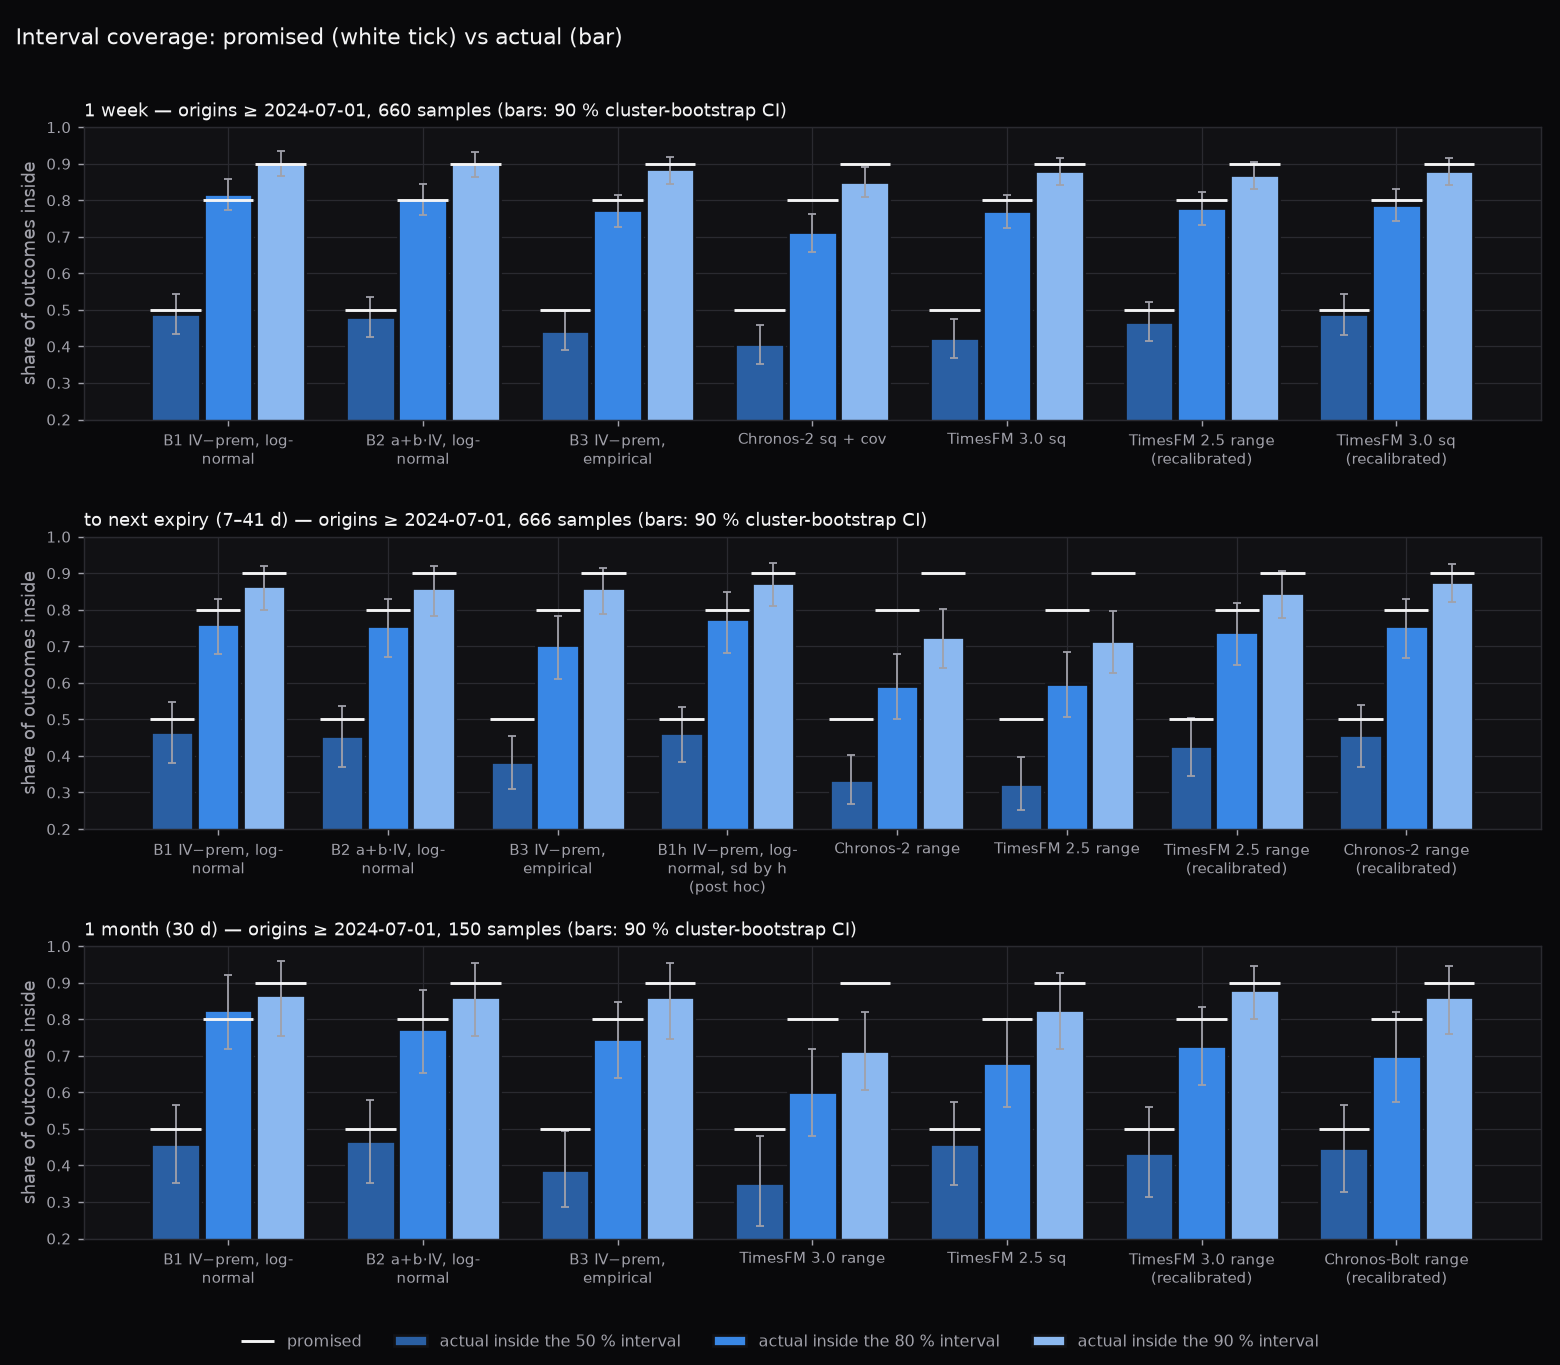
承诺(白色刻度)与实际(柱)的 coverage(覆盖率),2024 年 7 月起,带 90 % bootstrap(自助法)区间。
- 基准的区间是诚实的:2024 年 7 月以来三个期限都校准良好(80 % 区间包含 76–83 % 的结果)。放到全部历史上,它的中间部分略宽(50 % 区间接住 0.55),偏向于仓位更小。
- 所有基础模型的原始区间都太窄:80 % 区间只接住 48–78 %。再校准能修好覆盖率,但修不好精度:1 周期限上最接近的与基准相差不到 1 %(属于噪声范围),到下一个到期日和 1 个月期限上则全部更差。波动率飙升之后差 12–31 %。Chronos-2 输入收益平方时把飙升外推下去,在 2024 年 10 月 8 日给创业板ETF 预测的中位数是 238 % 的波动率。
- range-based 输入胜过收益平方:同一个模型,12 种情形中有 10 种更好,但优势不大,始终追不上基准。
- 区间宽度必须随到期天数变化。 所有交易用同一个宽度时,剩 4–10 个交易日的交易只有 66 % 落在 80 % 区间内,剩 20 天以上的是 88 %。几天的已实现波动率本身噪声就很大。让宽度随剩余天数缩小,两者都得到修正(76 % 和 84 %)。这是看过结果之后才发现的,再在样本外做了检验。
- 2024–26 年上尾偏重:6–9 % 的结果高于第 95 百分位,而承诺的是 5 %。对卖波动率的交易来说,这是亏钱的一侧。
- 1 周基本是噪声。 只有约五个日度变动,仅已实现波动率的抽样噪声就有约 0.35 的对数离散度,而基准的是 0.47:一半以上的不确定性是任何人都预测不了的。
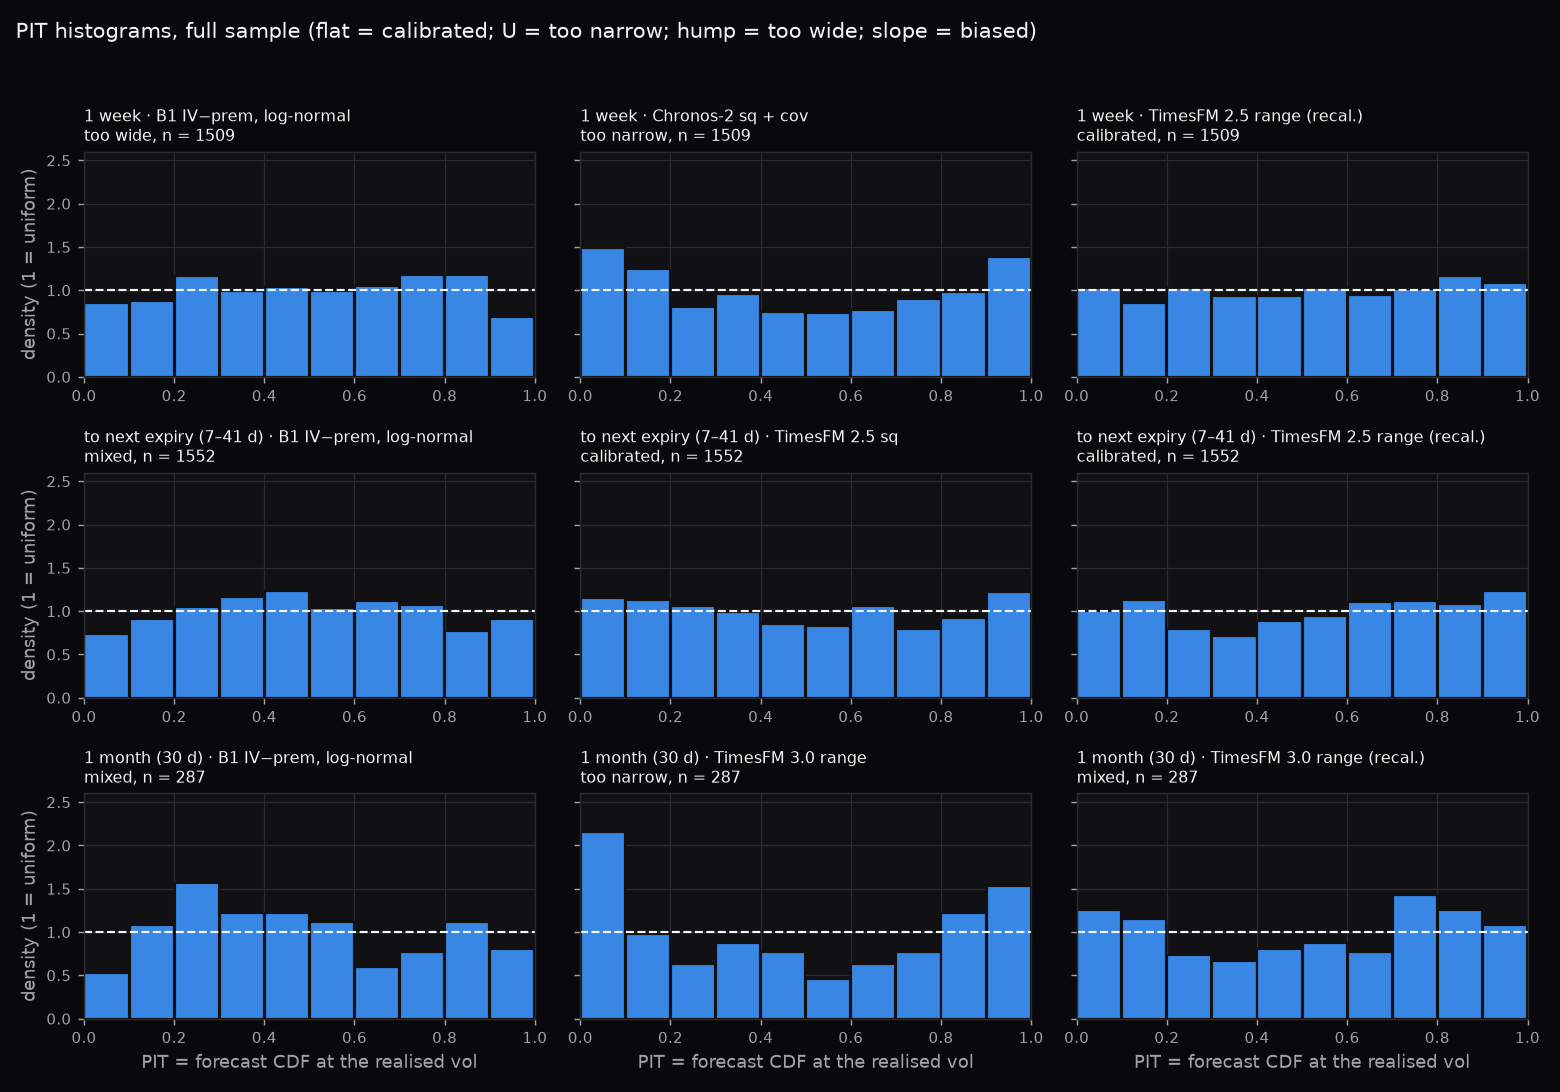
每个结果落在它自己预测分布的哪个位置(PIT),全部历史。平坦 = 诚实;U 形 = 区间太窄;驼峰 = 太宽。
App 据此做了什么
- 预测仍是 IV 减去溢价,而不是时间序列模型。 没有模型胜过它,也没有模型提供能通过检验的新信息;在飙升之后,模型明显更差。溢价原来是平值 IV 上固定的 1 点;自 2026 年 10 月起改为 IV 的 5 %,即预测为 0.95 × ATM IV(见下面的后续问题)。
- 不做混合。 最多好约 1 %,不显著,而且权重不稳定。
- Kelly 按波动率的一个区间定仓位,而不是一个数。 研究测得已实现波动率相对 IV − 溢价的误差呈对数正态,对数离散度为 √(0.064 + 0.86 / h),h 是距到期的交易日数(5 天 0.49,10 天 0.39,20 天 0.33)。第二部分 0.86 / h 主要是只用几天数据测量波动率带来的噪声,并不改变价格最终能走多远。所以 App 只保留第一部分,即每个期限都约 0.25 的对数离散度,并因为上尾偏重而把上半部分加宽。详见 按波动率区间计算 Kelly。
- TimesFM:值得记录,不值得切换。 输入收益平方时有潜力,但在 25 个干净日期上不显著。在 App 预测旁边逐日记录一年它的预测,才能回答 25 个日期回答不了的问题。
- 尚未排除:基于 5 分钟日内已实现波动率的真正 HAR 模型。App 没有采集这种精度的日内价格。
- 一个后续问题:下个月的波动率随 IV 的变化小于一比一(拟合斜率 b ≈ 0.78),所以固定溢价在 IV 高时会高估、在 IV 低时会低估。a + b·IV 在全部 21 个日期网格上都好约 2 %,但不显著。后续研究在平值 IV 上重新检验:样本外 0.95 × IV 胜过 IV 减去常数,App 于 2026 年 10 月改用它。
局限与注意事项
- 这里的 IV 是 QVIX:一个 model-free(无模型)的 30 天指数,比 App 使用的平值 IV 高 1–3 点。拟合的溢价和组合能吸收固定的差距,但吸收不了随市场环境变化的差距。
- 约 87 个独立日期有全部点预测(单看 IV − 溢价为 111 个,全部为 135 个)。2020 年之前只有 50ETF 有期权数据;从 2023 年起六只 ETF 走势一致,所以真正独立的单位是日期,而不是样本。三次压力事件(2015 年、2020 年 2 月、2024 年 9 月)决定了大部分误差。
- 区间结果只有 27 个到期日(1 个月期限为 25 个日期),都在 2024 年 7 月之后,其中只有一次压力事件。随到期天数收窄的宽度是看过结果之后才选定的。
- HAR 基于日度收益,不是日内数据,比教科书版本弱。
- 检验的行数很多。任何单个 t 值都应该对照约 3 的门槛来看。
- 未覆盖中证1000 股指期权(IM):它的公开波动率指数数据有问题。
自己复现
下面的脚本用公开数据重算本页的点预测和校准数字,不需要账号或密钥。基础模型部分是可选的。
数据(通过免费的 AKShare 获取):
| 内容 | AKShare 函数 | 起始 |
|---|---|---|
| ETF 日收盘价(新浪,未复权) | fund_etf_hist_sina("sh510050") 等 | 各 ETF 上市日 |
| 跟踪指数收盘价,仅用于识别份额拆分 | stock_zh_index_daily("sh000016") 等 | — |
| QVIX 日收盘值 | index_option_50etf_qvix()、_300etf_、_500etf_、_cyb_、_kcb_、_100etf_ | 2015-02-09(50ETF)至 2023-06(科创50) |
已实现波动率(收盘价对收盘价;目标保留每个交易日的收益):
def realized_vol(points, as_of, lookback_days, *, skip_gaps, drops):
    start = as_of - timedelta(days=lookback_days)
    window = [(d, p) for d, p in points if start <= d <= as_of]
    rets = [log(p1 / p0) for (d0, p0), (d1, p1) in zip(window, window[1:])
            if not (skip_gaps and (d1 - d0).days > 5) and d1 not in drops]
    m = sum(rets) / len(rets)
    return sqrt(sum((r - m) ** 2 for r in rets) / len(rets) * 252)
IV − 溢价和 a + b·IV 对照组,只用已经结束的窗口拟合:
closed = df["origin"] + pd.Timedelta(days=30) <= t      # 在日期 t 之前已结束的窗口
premium = (iv[closed] - rv[closed]).mean()
forecast = max(iv_today - premium, 0.01)
b, a = np.polyfit(iv[closed], rv[closed], 1)            # 对照组:a + b * iv_today
GARCH(1,1):在每个日期用截至当天的全部收益重新拟合,再对窗口内 h 个交易日取平均:
am = arch_model(returns_to_t * 100, mean="Constant", vol="GARCH", p=1, q=1, dist="normal")
res = am.fit(disp="off")
var_path = res.forecast(horizon=h).variance.to_numpy()[-1] / 1e4
garch_vol = sqrt(252 * var_path.mean())
HAR-RV:把未来 30 天的 252 × mean(r²) 对过去 1、5、22 天的 252 × mean(r²) 做回归,只用 30 天窗口已经结束的行(至少 250 行),再对预测值开平方。
校准:以 IV − 溢价为中心的对数正态,均值 m 和离散度 s 来自过去的对数误差:
err = np.log(rv[closed] / np.maximum(iv[closed] - premium, 0.01))
m, s = err.mean(), err.std(ddof=1)
z = abs(log(rv_next) - (log(forecast) + m)) / s
inside_80 = z <= NormalDist().inv_cdf(0.90)              # 1.2816
运行:
pip install -r requirements.txt
python vol_forecast.py --cache-dir data       # 只下载一次,之后约 10 秒
python vol_forecast.py --end none             # 包含发布之后的数据
基础模型(可选):python vol_forecast.py --with-fm 会加上 2024 年 7 月起、输入收益平方的 TimesFM 2.5。需要 pip install "timesfm[torch]>=3.0.2" "torch>=2.4"(连同 PyTorch 约 1 GB;CPU 即可,不到一分钟)。权重 google/timesfm-2.5-200m-pytorch 第一次使用时从 Hugging Face 下载;如果无法访问该网站,把 HF_ENDPOINT 设为镜像地址。脚本不包含 Kronos、Chronos 和 range 输入的基础模型。
本页与脚本对照。 2026 年 10 月 1 日运行,分别用研究保存的数据和重新从 AKShare 下载的数据,都截止到 2026 年 9 月 30 日(默认的 --end):
| 数字 | 本页 | 脚本 |
|---|---|---|
| 样本 / 日期 | 387 / 135 | 387 / 135 |
| 全部样本 RMSE:近期已实现波动率 / QVIX / IV − 溢价 | 10.81 / 9.98 / 9.69 | 10.81 / 9.98 / 9.69 |
| 共同样本 | 339 / 87 个日期 | 339 / 87 个日期 |
| RMSE:IV − 溢价 / a + b·IV | 9.78 / 9.60 | 9.78 / 9.60 |
| RMSE(相对 IV − 溢价):GARCH(1,1) | 11.39(1.165) | 11.39(1.165) |
| RMSE(相对 IV − 溢价):HAR-RV | 11.10(1.135) | 11.10(1.135) |
| 1 个月区间落在 50 / 80 / 90 % 内,2024 年 7 月起(150) | 0.46 / 0.83 / 0.87 | 0.46 / 0.83 / 0.87 |
| 同上,全部历史(287) | 0.52 / 0.87 / 0.91 | 0.52 / 0.87 / 0.91 |
TimesFM 2.5 对 IV − 溢价,2024 年 7 月起(--with-fm) | 12.03 对 12.90(0.933,t −1.66) | 12.03 对 12.90(0.933,t −1.66) |
容差:所有数字都与本页显示的最后一位一致。在同样的数据上,应能保持在 ±0.01 个波动率点、覆盖率 ±0.01 之内。换一个版本的 arch 库或优化器,GARCH 拟合可能略有变化,所以 GARCH 几行允许 ±0.05 点。数据供应商可能修订旧数据,--end none 也会加入发布之后结束的月份,两者都会让所有数字略有变动。到下一个到期日和 1 周期限的区间,以及其他基础模型,需要每周的样本网格和各模型自己的软件包,脚本不复现这些结果。
下载脚本
独立的 Python 脚本,只使用公开数据(AKShare)。先安装 requirements.txt 中的依赖,再运行脚本。